Home
» Tecnologia
»
Semiconduttori di nuova generazione: come l'intelligenza artificiale e il supercalcolo si stanno spingendo oltre i transistor più piccoli
Semiconduttori di nuova generazione: come l'intelligenza artificiale e il supercalcolo si stanno spingendo oltre i transistor più piccoli
In breve: i progressi dell'IA ora derivano dall'intero sistema dei semiconduttori.
La prossima generazione di hardware per l'intelligenza artificiale e il supercalcolo non si basa su una singola innovazione rivoluzionaria. Si sta costruendo a partire da diverse tecnologie che devono lavorare in sinergia: transistor gate-all-around, alimentazione dal lato posteriore, architetture a chiplet, packaging avanzato, memorie ad alta larghezza di banda, collegamenti die-to-die più veloci e reti ottiche in continua espansione. Il risultato pratico è una maggiore potenza di calcolo, una maggiore larghezza di banda della memoria e una migliore scalabilità, senza dover ricorrere esclusivamente a dimensioni dei transistor più piccole.
Questo è importante perché i moderni acceleratori di intelligenza artificiale e i supercomputer scientifici spesso raggiungono i limiti di trasferimento dati e di potenza prima ancora di esaurire la loro capacità di calcolo. Un motore di matrici più veloce è utile solo se i pesi del modello, le attivazioni e i risultati intermedi possono raggiungerlo abbastanza rapidamente. Allo stesso modo, aggiungere altri acceleratori è utile solo se il pacchetto, la rete rack, il sistema di memoria, il sistema di raffreddamento e lo stack software sono in grado di mantenerli occupati.
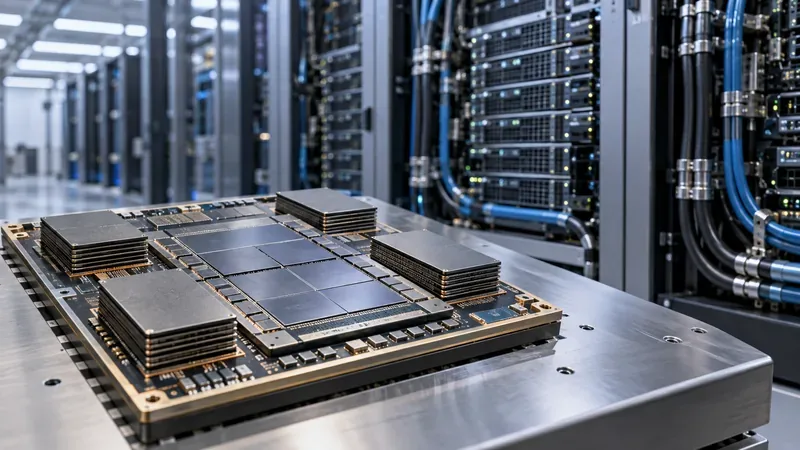
Un modulo acceleratore multi-chip con diversi pacchetti di memoria sovrapposti illustra la direzione intrapresa dall'hardware moderno per l'intelligenza artificiale: elaborazione, memoria, packaging, alimentazione e raffreddamento sono sempre più progettati come un unico sistema.
1. Le nuove strutture dei transistor migliorano l'efficienza, ma sono solo il punto di partenza.
La logica di ultima generazione si sta allontanando dalla struttura FinFET che ha dominato i chip avanzati per anni. I progetti gate-all-around, o GAA, avvolgono il gate attorno a un nanosheet o a una struttura di canale simile, offrendo ai progettisti di chip un controllo elettrostatico più preciso man mano che le dimensioni dei componenti si riducono. Ciò può migliorare le prestazioni, ridurre le correnti di dispersione o fornire un migliore equilibrio tra le due.
TSMC afferma che il suo processo N2 a 2 nanometri è entrato in produzione di massa nel quarto trimestre del 2025, mentre la sua tecnologia A16 combina transistor a nanosheet con una linea di alimentazione posteriore pensata in particolare per prodotti di calcolo ad alte prestazioni con elevate esigenze di alimentazione. TSMC ha dichiarato che la produzione di massa di A16 è prevista per la seconda metà del 2026. Consultare la pagina della fonderia dedicata alla tecnologia A16 e la relazione annuale del 2025 .
Intel sta seguendo una direzione simile con Intel 18A. Il suo processo combina transistor RibbonFET GAA con l'alimentazione PowerVia sul lato posteriore. Intel afferma che la produzione di 18A è iniziata nel 2025, mentre la versione migliorata 18A-P è entrata in produzione di prova nel giugno 2026. Intel pubblica anche dati comparativi su prestazioni, consumo energetico e densità per questo nodo; tali cifre sono fornite dal produttore e dovrebbero essere validate rispetto a un progetto specifico piuttosto che essere considerate come miglioramenti universali a livello di chip. I dettagli aggiornati sono disponibili sulla pagina del processo Intel 18A .
L'alimentazione sul lato posteriore è importante perché i chip avanzati devono instradare sia i segnali che l'alimentazione attraverso un cablaggio estremamente denso. Spostare parte della rete di alimentazione sul lato posteriore può liberare risorse di instradamento sul lato dei segnali e migliorare l'erogazione di tensione. Per gli acceleratori di intelligenza artificiale, dove grandi array di unità di calcolo commutano ad alta velocità, questo può essere importante quanto la densità dei transistor.
2. I chiplet e il packaging avanzato stanno trasformando un pacco in un piccolo sistema informatico.
I chip monolitici diventano sempre più difficili e costosi da scalare man mano che crescono. I chiplet offrono un'alternativa: le singole funzioni possono essere prodotte con tecnologie di processo più adatte e poi collegate all'interno di un unico package. Un chip di calcolo potrebbe richiedere il processo logico più avanzato, mentre I/O, cache, circuiti analogici o altre funzioni potrebbero non averne bisogno.
È il packaging a rendere tutto ciò pratico. La piattaforma di packaging avanzato CoWoS di TSMC , ad esempio, è progettata per integrare più dispositivi logici e stack di memoria ad alta larghezza di banda in un package 2.5D. TSMC posiziona CoWoS specificamente per i prodotti di intelligenza artificiale e calcolo ad alte prestazioni (HPC), dove le connessioni brevi e ampie tra il calcolo e la memoria ad alta larghezza di banda sono fondamentali.
Stanno inoltre emergendo standard per rendere i chiplet meno proprietari. La specifica UCIe 3.0 , rilasciata nell'agosto 2025, supporta velocità di trasmissione dati di 48 GT/s e 64 GT/s e aggiunge funzionalità per l'efficienza energetica, la gestibilità e sistemi multi-chip più flessibili. UCIe non rende i chiplet intercambiabili dall'oggi al domani, ma fornisce al settore un framework elettrico e di protocollo comune per i collegamenti on-package.
Questo approccio è particolarmente interessante quando un'azienda desidera realizzare diverse varianti di acceleratori utilizzando componenti riutilizzabili. È meno attraente quando il costo del package, la densità termica o la complessità del design superano i vantaggi della modularità. Un prodotto più piccolo con esigenze di memoria e I/O modeste potrebbe comunque essere gestito meglio da un dispositivo monolitico più semplice.
3. La memoria ad alta larghezza di banda sta diventando strategica quanto l'acceleratore stesso.
I carichi di lavoro dell'IA trasferiscono ripetutamente tensori di grandi dimensioni tra la memoria e le unità di calcolo. Ciò rende la larghezza di banda della memoria un vincolo di progettazione di primaria importanza. La memoria ad alta larghezza di banda, o HBM, risolve il problema impilando i chip DRAM e posizionandoli fisicamente vicino all'acceleratore tramite un'interfaccia molto ampia.
La tecnologia HBM4 sta passando dalla fase di roadmap alla sua commercializzazione. Samsung ha annunciato le prime spedizioni commerciali di HBM4 nel febbraio 2026, affermando che il prodotto è entrato in produzione di massa con una velocità di trasferimento sostenuta di 11,7 Gb/s, con una capacità fino a 13 Gb/s. Nel maggio 2026, Samsung ha anche annunciato la spedizione di campioni di HBM4E. Ulteriori dettagli sono disponibili nell'annuncio di Samsung relativo alla produzione di HBM4 .
SK hynix ha dichiarato nei risultati del secondo trimestre 2026 di aver avviato le spedizioni di massa di HBM4 durante il trimestre e di prevedere un aumento della produzione nella seconda metà dell'anno. L'azienda ha inoltre spedito campioni di HBM4E a 12 strati. Per lo stato attuale, si vedano i risultati del secondo trimestre 2026 di SK hynix .
Perché è importante nella pratica? Le attuali specifiche di NVIDIA per Vera Rubin indicano 288 GB di HBM4 su una GPU Rubin e una larghezza di banda della memoria GPU di 19,2 TB/s. Per confronto, gli acceleratori della serie MI350 di AMD utilizzano HBM3E; AMD indica fino a 288 GB e 8 TB/s per il MI355X. Si tratta di architetture diverse e non dovrebbero essere confrontate basandosi solo su un dato di larghezza di banda, ma entrambe illustrano come la capacità di memoria e la larghezza di banda siano ormai specifiche fondamentali per gli acceleratori, piuttosto che dettagli secondari. Consultare le specifiche ufficiali di NVIDIA Vera Rubin NVL72 e la pagina della serie AMD Instinct MI350 .
4. Le interconnessioni di scalabilità verticale e orizzontale determinano se molti acceleratori si comportano come uno
Modelli complessi e simulazioni scientifiche raramente si adattano perfettamente a un singolo dispositivo. Il sistema deve suddividere il lavoro tra più acceleratori e scambiare frequentemente risultati parziali. Se la comunicazione è lenta, le costose unità di calcolo rimangono inattive.
Ecco perché le tecnologie proprietarie di scalabilità si stanno evolvendo di pari passo con le GPU stesse. La piattaforma Rubin di NVIDIA utilizza NVLink di sesta generazione; NVIDIA dichiara una larghezza di banda NVLink di 3 TB/s per GPU Rubin e di 216 TB/s su un sistema NVL72. AMD utilizza Infinity Fabric su tutte le sue piattaforme di accelerazione. Per gli acquirenti, la questione importante non è solo la larghezza di banda di collegamento di picco, ma anche come si comporta la tecnologia in base alle precise operazioni collettive, ai modelli paralleli e alla topologia utilizzati dall'applicazione.
Anche a livello di memoria di sistema, Compute Express Link si sta evolvendo. Il consorzio CXL afferma che CXL 4.0 raddoppia la velocità di segnalazione da 64 GT/s a 128 GT/s, aggiunge porte raggruppate ed espande le funzionalità di affidabilità della memoria. CXL è rilevante quando gli architetti desiderano un'espansione, un pooling o una disaggregazione coerente della memoria senza trattare ogni livello di memoria come un dispositivo di archiviazione remoto.
5. La fotonica al silicio si sta avvicinando alla commutazione del silicio
Il rame rimane un'ottima soluzione per connessioni elettriche brevi e dense, ma i collegamenti ottici diventano sempre più interessanti con l'aumentare della distanza e della larghezza di banda complessiva. Un importante passo successivo è rappresentato dall'ottica integrata, in cui i componenti ottici vengono avvicinati al circuito integrato di rete (ASIC) anziché risiedere interamente in ricetrasmettitori plug-in ai margini di uno switch.
NVIDIA afferma che la sua piattaforma Spectrum-X Ethernet Photonics utilizza componenti ottici integrati e offre un'efficienza energetica di rete fino a 5 volte superiore rispetto ai tradizionali design con ricetrasmettitori plug-in. Si tratta di un confronto tra fornitori, non di una garanzia per ogni topologia di data center, ma evidenzia la direzione intrapresa: il consumo energetico di rete sta diventando un fattore così rilevante che l'integrazione ottica è ormai parte integrante della progettazione dei sistemi a semiconduttore. Per maggiori informazioni, consultare la panoramica sulla fotonica al silicio di NVIDIA .
Cosa significa questo per l'intelligenza artificiale reale e i carichi di lavoro di supercalcolo
Carico di lavoro
Caratteristiche dei semiconduttori da privilegiare
Perché sono importanti
Pre-addestramento di modelli di grandi dimensioni
Capacità e larghezza di banda HBM, collegamenti di scalabilità rapida, confezionamento denso, raffreddamento potente
L'addestramento si concentra in gran parte sul movimento dei tensori e sulla comunicazione sincronizzata tra numerosi acceleratori.
Inferenza a lungo termine e agentiva
Grandi pool HBM, calcolo efficiente a bassa precisione, elevata larghezza di banda di interconnessione, tiering della memoria
La cache KV e le fasi di ragionamento ripetute possono rendere la capacità di memoria e il trasferimento dei dati più limitanti rispetto al picco di FLOPS.
HPC chirurgico
Capacità FP64, larghezza di banda della memoria, interconnessioni affidabili, librerie numeriche mature
I codici di simulazione spesso dipendono dalla doppia precisione e da una larghezza di banda sostenuta, piuttosto che dalla sola velocità di elaborazione dei tensori a bassa precisione.
Deduzione aziendale
Prestazioni per watt, compatibilità software, memoria di dimensioni adeguate, opzioni di implementazione PCIe
Il sistema migliore potrebbe essere quello che si adatta ai server e ai consumi energetici esistenti, piuttosto che quello che punta alla massima densità di rack.
Acceleratori personalizzati
Strategia per i chiplet, ecosistema di packaging, supporto UCIe, maturità del processo
La modularità può accorciare i cicli di riutilizzo, ma la complessità dell'imballaggio e la qualificazione della catena di fornitura possono vanificare questo vantaggio.
Un esempio concreto: perché una GPU più veloce non è sufficiente
Consideriamo un team che gestisce un modello linguistico di grandi dimensioni con finestre di contesto lunghe. Supponiamo che la profilazione mostri che le GPU sono spesso in attesa di trasferimenti di memoria e comunicazioni tra GPU. Il passaggio a un acceleratore più recente potrebbe essere d'aiuto, ma solo se il nuovo sistema offre anche una capacità HBM sufficiente, una larghezza di banda di memoria più elevata e una topologia che riduce i blocchi di comunicazione. Acquistare un dispositivo con prestazioni tensoriali teoriche superiori, mantenendo gli stessi colli di bottiglia di memoria e di rete, potrebbe portare a miglioramenti molto inferiori a quanto suggerito dalle specifiche principali.
Lo stesso principio si ritrova nel supercalcolo tradizionale. Il sistema Frontier dell'Oak Ridge National Laboratory combina acceleratori AMD MI250X con memoria HBM e un'interconnessione di sistema ad alta velocità. La guida utente di Frontier documenta il funzionamento congiunto di calcolo, memoria HBM, collegamenti CPU-GPU e rete Slingshot. L'hardware è di generazione precedente rispetto alle più recenti piattaforme di intelligenza artificiale del 2026, ma la lezione architetturale rimane valida: le prestazioni costanti di un'applicazione dipendono dal percorso tra calcolo, memoria e altri nodi.
Quando conviene passare all'hardware a semiconduttori di nuova generazione?
Un aggiornamento è più giustificabile quando risolve un collo di bottiglia misurabile, piuttosto che limitarsi a sostituire un componente obsoleto. Prima di optare per una nuova generazione di acceleratori, verificare quanto segue:
Pressione sulla memoria: il modello o la simulazione intasano la memoria host, richiedono checkpoint frequenti o impongono un livello di partizionamento del modello eccessivamente oneroso?
Pressione sulla larghezza di banda: i kernel sono limitati dalla memoria durante la profilazione, oppure gli acceleratori impiegano un tempo significativo in attesa di tutte le operazioni di riduzione e altre operazioni collettive?
Alimentazione e raffreddamento: il rack, la struttura e il circuito di raffreddamento sono in grado di supportare la nuova densità di potenza? Prestazioni superiori potrebbero comunque non essere adatte se gli aggiornamenti infrastrutturali rappresentano la parte preponderante dei costi.
Prontezza del software: il compilatore, le librerie, i kernel, lo stack di orchestrazione e gli strumenti di monitoraggio sono maturi per la nuova architettura?
Requisiti di precisione: il carico di lavoro può utilizzare in sicurezza formati a precisione inferiore, oppure richiede FP64 o un altro percorso a precisione superiore?
Utilizzo: Il carico di lavoro manterrà il nuovo hardware sufficientemente occupato da giustificarne il costo? La capacità inutilizzata non diventa economicamente vantaggiosa solo perché il chip è più recente.
I compromessi stanno diventando più concreti
I progressi nel campo dei semiconduttori stanno producendo capacità impressionanti, ma i fattori limitanti sono sempre più tangibili. I package avanzati sono più grandi e più difficili da produrre. Gli stack HBM concentrano il calore in prossimità della logica ad alta potenza. I sistemi su scala rack possono richiedere raffreddamento a liquido, una distribuzione di potenza densa e reti specializzate. L'ottica co-confezionata può ridurre il consumo energetico della rete, ma introduce nuove considerazioni in termini di produzione e manutenzione. I chiplet possono migliorare la modularità, ma aggiungono lavoro di validazione, confezionamento e gestione della resa.
Esiste anche un compromesso a livello software. L'aritmetica a bassa precisione, come FP8, FP6 o FP4, può aumentare notevolmente la produttività dell'IA, ma il software deve preservare la qualità del modello. I codici scientifici potrebbero non essere in grado di utilizzare le stesse scorciatoie. Una caratteristica di un semiconduttore è utile solo quando lo stack applicativo può sfruttarla senza violare i requisiti di accuratezza o affidabilità.
Cosa guardare dopo
Per il resto del 2026 e per tutto il 2027, i segnali più utili non si limiteranno ai nuovi nomi dei nodi. Bisognerà osservare se i processi A16 di TSMC e della famiglia 18A di Intel si diffonderanno ampiamente nei prodotti destinati ai clienti; con quale rapidità HBM4 e HBM4E diventeranno disponibili su larga scala; se UCIe 3.0 creerà una significativa interoperabilità tra chiplet di diversi fornitori; dove farà la sua comparsa CXL 4.0 nei sistemi di produzione; e se le ottiche co-confezionate si dimostreranno economiche e gestibili su larga scala.
Questi traguardi dimostreranno se l'industria dei semiconduttori sarà in grado di continuare a scalare l'intelligenza artificiale e il supercalcolo senza che lo spostamento della memoria, l'alimentazione, la rete e il raffreddamento annullino i vantaggi ottenuti grazie alla maggiore densità logica.
In conclusione
Il futuro dell'IA e del supercalcolo non è più alimentato da un singolo "nodo di nuova generazione", ma da un'ingegneria dei semiconduttori coordinata. I transistor GAA e l'alimentazione posteriore migliorano le fondamenta logiche. I chiplet e il packaging avanzato consentono ai progettisti di assemblare sistemi più grandi di quanto un singolo die possa comodamente fornire. La memoria HBM4 alimenta gli acceleratori con una larghezza di banda estrema. UCIe, CXL, NVLink, Infinity Fabric e le reti ottiche trasferiscono dati su domini progressivamente più ampi.
Se stai scegliendo l'hardware, parti dal vero collo di bottiglia del tuo carico di lavoro. Per l'IA limitata dalla memoria, dai priorità alla capacità HBM e alla larghezza di banda. Per l'addestramento distribuito, dai priorità all'infrastruttura di scalabilità verticale e orizzontale. Per il calcolo scientifico, verifica le prestazioni FP64 e delle librerie. Per l'implementazione aziendale, includi nella decisione alimentazione, raffreddamento, supporto software e impegno di integrazione. Il semiconduttore più veloce sulla carta non è automaticamente il sistema più veloce o più economico per il tuo carico di lavoro.