Home
» Tecnologia
»
Quali sono le cause dei frequenti tempi di inattività delle piattaforme cloud? Gli schemi di errore alla base delle principali interruzioni.
Quali sono le cause dei frequenti tempi di inattività delle piattaforme cloud? Gli schemi di errore alla base delle principali interruzioni.
I periodi di inattività diffusi delle piattaforme cloud raramente derivano dal semplice "blocco" di un singolo server. Gli incidenti più critici di solito iniziano con un guasto tecnico, come una configurazione errata, un difetto del software, un problema DNS, un guasto di rete o un evento infrastrutturale, per poi propagarsi poiché molti servizi dipendono dagli stessi piani di controllo, database, sistemi di identità, bilanciatori di carico o risorse regionali.
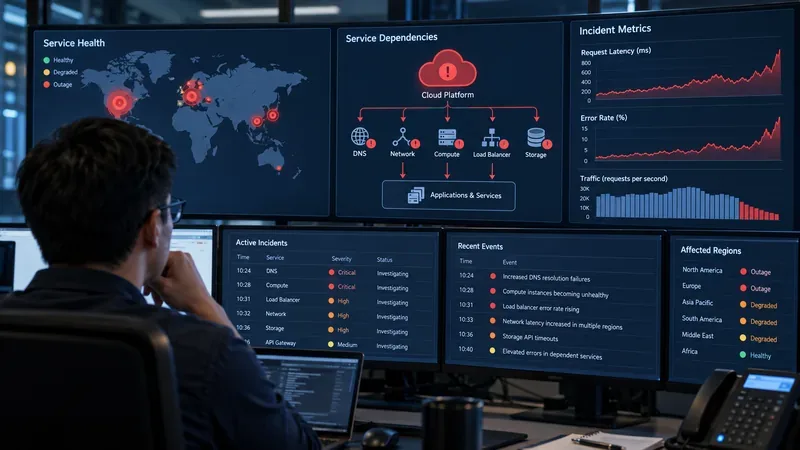
Scenario esemplificativo: immaginiamo un fornitore di servizi cloud fittizio chiamato Northstar Cloud. Alle 10:05, viene applicata una modifica automatica alla rete di un servizio regionale. Nel giro di pochi minuti, i clienti iniziano a segnalare errori nelle chiamate API. Alle 10:12, l'avvio di nuove macchine virtuali si interrompe. Alle 10:20, i bilanciatori di carico iniziano a contrassegnare come non disponibili backend funzionanti. Entro le 10:35, decine di prodotti apparentemente non correlati tra loro presentano un degrado delle prestazioni. Questo scenario è ipotetico e non descrive un'interruzione reale. È utile perché mostra come un piccolo errore iniziale possa trasformarsi in un evento di grandi dimensioni a livello di piattaforma.
I team addetti alle operazioni cloud spesso devono risalire all'origine di un'interruzione di servizio, partendo dal primo componente che ha smesso di funzionare, passando per DNS, rete, elaborazione, bilanciamento del carico, archiviazione e applicazioni a valle.
In breve: i guasti più gravi del cloud sono solitamente guasti a cascata.
Le principali cause alla base di interruzioni diffuse delle piattaforme cloud sono errori di configurazione e implementazione, difetti software latenti, guasti DNS e di routing, dipendenze da servizi condivisi, esaurimento della capacità durante un guasto o il ripristino, problemi del piano di controllo e guasti fisici che interessano un data center o una zona di disponibilità. L'entità dell'interruzione dipende meno dal primo errore e più da quanto ampiamente il componente interessato sia condiviso.
Un utile esempio concreto proviene da AWS. Nel suo riepilogo ufficiale post-evento relativo all'interruzione del servizio avvenuta nell'ottobre 2025 nella Virginia settentrionale, AWS ha dichiarato che una condizione di gara latente nel sistema di gestione DNS automatizzato di DynamoDB ha generato un record DNS vuoto errato per l'endpoint regionale. Tale errore DNS ha interessato i clienti e i servizi interni di AWS che dipendevano da DynamoDB, e le successive operazioni di ripristino hanno contribuito a problemi relativi all'avvio di istanze EC2 e ai Network Load Balancer. L'incidente è documentato nel riepilogo post-evento di AWS relativo all'interruzione del servizio DynamoDB dell'ottobre 2025 .
1. Le modifiche alla configurazione possono creare un raggio d'esplosione inaspettatamente ampio
Gli errori di configurazione sono tra gli schemi più comuni negli incidenti che coinvolgono grandi sistemi distribuiti, poiché le piattaforme moderne sono controllate tramite automazione. Una singola modifica può essere implementata su migliaia di host, router, record DNS o endpoint di servizio più velocemente di quanto un operatore umano potrebbe fare manualmente.
Torniamo allo scenario di Northstar Cloud. Supponiamo che la modifica alla rete delle 10:05 fosse destinata a dieci macchine, ma sia stata applicata a diverse regioni. La modifica non deve necessariamente distruggere l'hardware. Potrebbe semplicemente rimuovere capacità di rete utilizzabile, modificare il routing o causare il rifiuto di traffico altrimenti legittimo da parte dei sistemi. Quando la capacità condivisa scende al di sotto della domanda, i clienti riscontrano timeout e tentativi di riconnessione, che creano un carico ancora maggiore.
Google ha descritto un meccanismo simile nel suo resoconto ufficiale di un'interruzione del servizio avvenuta nel 2019: una modifica di configurazione destinata a un numero limitato di server in una regione è stata applicata erroneamente in modo molto più esteso, causando l'interruzione dell'utilizzo di oltre la metà della capacità di rete disponibile in diverse regioni. Il traffico ha quindi congestionato la capacità rimanente. Si veda l'aggiornamento ufficiale di Google sull'interruzione del servizio del 2019 .
Ecco perché gli operatori cloud più esperti utilizzano implementazioni graduali, convalida, rollback automatizzato, limiti di frequenza delle modifiche e controlli di "raggio d'azione". Queste misure di sicurezza non eliminano gli incidenti, ma possono impedire che una singola modifica errata si trasformi in un evento che coinvolge l'intera piattaforma.
2. I difetti del software possono rimanere nascosti fino a quando non si verificano rare condizioni temporali
Le grandi piattaforme cloud gestiscono enormi quantità di software distribuito. Alcuni difetti rimangono latenti per mesi o anni perché richiedono una rara sequenza di eventi: due controller che aggiornano lo stesso stato, un ritardo insolito, metadati obsoleti o un processo di ripristino in esecuzione contemporaneamente a un processo di pulizia.
Nell'ipotetico incidente Northstar, immaginiamo che due processi di automazione indipendenti aggiornino lo stesso piano DNS. Uno dei due subisce un ritardo, l'altro completa un aggiornamento più recente e una routine di pulizia rimuove i dati che il processo ritardato ha appena attivato. Ciascun componente può sembrare funzionare come previsto, ma la loro interazione crea uno stato non valido.
L'evento AWS DynamoDB del 2025 illustra chiaramente questa categoria. AWS ha attribuito l'errore iniziale a una condizione di competizione latente tra componenti ridondanti di gestione DNS. Il significato va oltre un singolo fornitore: la ridondanza migliora l'affidabilità solo quando i componenti ridondanti non possono corrompere lo stato condiviso attraverso lo stesso errore logico o di sincronizzazione.
3. I guasti DNS e di rete possono rendere irraggiungibili i sistemi funzionanti
Un servizio può essere completamente attivo e risultare comunque di fatto non disponibile se i clienti non riescono a risolverne il nome host o se i pacchetti non riescono a raggiungerlo. Pertanto, DNS, routing, bilanciamento del carico e configurazione di rete sono elementi critici per quasi tutti i prodotti cloud.
Nell'esempio di Northstar, i clienti potrebbero presumere che il servizio di calcolo stesso sia inattivo perché le chiamate API vanno in timeout. Tuttavia, i server di calcolo effettivi potrebbero essere funzionanti, mentre il DNS potrebbe non restituire alcun endpoint utilizzabile, potrebbe mancare una rotta o un bilanciatore di carico potrebbe aver rimosso destinazioni funzionanti.
AWS ha documentato questa modalità di errore più di una volta. In un incidente verificatosi nel 2018 nella regione di Seul, AWS ha dichiarato che un aggiornamento della configurazione aveva rimosso erroneamente un'impostazione che specificava il numero minimo di host funzionanti per la flotta di resolver DNS di EC2. La ridotta capacità dei resolver ha quindi causato il fallimento delle query DNS provenienti dalle istanze EC2. I dettagli sono disponibili nel riepilogo AWS del problema di risoluzione DNS di EC2 del 2018 a Seul .
I guasti di rete si amplificano rapidamente perché le applicazioni ritentano le connessioni non riuscite. Un comportamento aggressivo in termini di tentativi di connessione può trasformare un malfunzionamento parziale della rete in un picco di traffico molto più elevato.
4. Le dipendenze condivise fanno sì che servizi non correlati falliscano contemporaneamente
I servizi cloud non sono prodotti isolati. Un database gestito può dipendere da servizi di identità, DNS interno, storage, rete, sistemi di pianificazione, servizi di certificazione e telemetria. Una piattaforma serverless può dipendere da capacità di calcolo, rete, sistemi di accodamento e database del piano di controllo. Se una dipendenza condivisa si guasta, molti prodotti possono subire un degrado simultaneo.
Questo spiega uno dei sintomi più ingannevoli di un'interruzione di servizio: i clienti riscontrano errori in diversi servizi e presumono che si siano verificati diversi guasti indipendenti. In realtà, i guasti visibili potrebbero avere tutti la stessa causa a monte.
Nello scenario Northstar, il servizio di macchine virtuali, il servizio di container e il servizio serverless potrebbero tutti iniziare a fallire perché dipendono dallo stesso database di risorse interno. I prodotti rivolti al cliente sono diversi; la dipendenza sottostante, tuttavia, è la stessa.
L'incidente di AWS dell'ottobre 2025 ha mostrato questo tipo di effetto a cascata, quando i servizi interni che si basavano su DynamoDB sono stati colpiti dal problema DNS iniziale, seguito da effetti di ripristino a valle su EC2, Network Load Balancer, Lambda, servizi di container, funzioni relative all'identità e altri prodotti.
5. Il ripristino può fallire perché il backlog è maggiore del normale carico operativo.
Il ripristino del componente difettoso originale non sempre pone fine a un'interruzione. Durante i periodi di inattività, le code si allungano, i contratti di leasing scadono, i controlli di integrità falliscono, gli autoscaler richiedono capacità sostitutiva, i client ritentano le richieste e gli aggiornamenti di configurazione si accumulano. Quando la dipendenza non funzionante torna disponibile, ogni sistema in attesa potrebbe tentare di ripristinarsi contemporaneamente.
Nell'esempio di Northstar, supponiamo che il DNS venga riparato alle 10:45. Migliaia di host di calcolo tentano ora di rinnovare i lease scaduti. Allo stesso tempo, i clienti riprovano le implementazioni non riuscite e i sistemi di scalabilità automatica richiedono istanze sostitutive. Il piano di controllo si trova improvvisamente a elaborare un carico di lavoro molte volte superiore al normale. Se non dispone di limiti di velocità efficaci o di una prioritizzazione del ripristino, può entrare in una seconda modalità di errore anche se il bug originale è stato risolto.
Nel 2025 AWS ha descritto un problema di ripristino simile: dopo il ripristino dell'accesso a DynamoDB, un sottosistema EC2 ha dovuto ristabilire un gran numero di lease. L'arretrato è diventato difficile da elaborare prima che si verificassero i timeout e AWS ha affermato che il sottosistema è entrato in uno stato di "collasso congestivo". Questo dettaglio è importante perché mostra perché la durata dell'interruzione può essere molto più lunga del tempo necessario per risolvere il problema iniziale.
6. I controlli di integrità e il failover automatico possono talvolta rimuovere capacità valide
I controlli di integrità sono essenziali, ma si basano anche su processi decisionali automatizzati. Se una rete è lenta o la propagazione dello stato è ritardata, un sistema di controllo di integrità potrebbe concludere che le risorse che prima erano integre ora sono difettose e rimuoverle dal servizio. Ciò può ridurre ulteriormente la capacità, creando un circolo vizioso.
Nello scenario fittizio, i bilanciatori di carico di Northstar iniziano a controllare le istanze appena avviate prima che la configurazione di rete si sia propagata completamente. I controlli falliscono, le istanze funzionanti vengono ritirate, il traffico si sposta verso un numero inferiore di nodi rimanenti e questi nodi si sovraccaricano.
Questo schema si è ripresentato anche durante l'evento AWS del 2025. AWS ha affermato che i controlli di integrità del Network Load Balancer a volte fallivano mentre lo stato di rete per le nuove istanze era ancora in fase di propagazione, il che comportava la rimozione di capacità dal servizio. Questo ci ricorda che la logica di failover deve essere limitata in termini di frequenza e testata in caso di guasto parziale, non solo in condizioni ottimali di "integrità/non integrità".
7. Rimangono possibili guasti ai data center, all'alimentazione, al sistema di raffreddamento e alle zone di disponibilità.
Non tutti i guasti hanno origine nel software. Anche l'alimentazione, il raffreddamento, la fibra ottica, l'hardware di rete e altre infrastrutture fisiche possono guastarsi. L'architettura cloud è progettata tenendo conto di questa realtà, ed è per questo che i principali provider suddividono le regioni in zone isolate in base ai guasti.
Microsoft spiega che le Zone di disponibilità di Azure sono gruppi separati di data center con alimentazione, raffreddamento e rete indipendenti. Microsoft precisa inoltre che una distribuzione zonale non sopravvive automaticamente a un'interruzione di servizio di una zona; i clienti devono utilizzare più zone o servizi di ridondanza di zona, ove supportati. Per ulteriori informazioni, consultare la panoramica ufficiale delle Zone di disponibilità di Azure di Microsoft .
In termini pratici, un fornitore di servizi cloud può rendere una zona indipendente, ma un carico di lavoro del cliente potrebbe comunque avere un database a zona singola, una dipendenza da un singolo controllo regionale o un processo di failover che non è mai stato eseguito.
Perché un'interruzione del servizio cloud può sembrare globale anche quando la causa principale è regionale
Spesso, la dicitura "interruzione globale" descrive l'impatto sui clienti, non la posizione fisica delle apparecchiature guaste. Un servizio regionale può supportare l'autenticazione, il DNS, i metadati, le pipeline di build, le dashboard o le API di controllo utilizzate da altre regioni. Di conseguenza, le applicazioni in tutto il mondo possono smettere di funzionare perché dipendono da un servizio concentrato in un'unica posizione.
La distinzione è importante quando si diagnostica un incidente. Gli ingegneri dovrebbero porsi due domande diverse: Dove si è verificato il primo guasto? e Quali dipendenze hanno permesso a tale guasto di propagarsi? Le risposte a queste domande sono spesso diverse.
Come identificare la causa probabile durante un incidente in corso
Per gli operatori, la strada più rapida è solitamente quella di correlare i sintomi piuttosto che analizzare ogni prodotto separatamente. Se molti servizi si bloccano contemporaneamente, è necessario individuare una dipendenza condivisa. Se i carichi di lavoro esistenti rimangono integri mentre le nuove implementazioni falliscono, è opportuno sospettare un problema di piano di controllo, pianificazione, capacità o provisioning. Se la connettività IP funziona ma i nomi dei servizi non sono disponibili, è necessario esaminare il DNS. Se i tassi di errore aumentano dopo un annuncio di ripristino, è necessario individuare tempeste di tentativi, backlog, lease scaduti, cicli di feedback dei controlli di integrità o capacità di ripristino insufficiente.
I sistemi di stato dei provider possono anche aiutare a distinguere un incidente della piattaforma da un guasto specifico dell'applicazione. Google Cloud, ad esempio, pubblica gli incidenti attuali e storici tramite la sua dashboard ufficiale Service Health , mentre AWS pubblica i riepiloghi degli eventi principali tramite i suoi riepiloghi ufficiali Post-Event .
Cosa possono fare i clienti per ridurre l'impatto
Nessuna architettura può garantire zero tempi di inattività, ma diverse scelte di progettazione riducono l'esposizione al rischio. Utilizzare più zone di disponibilità per i carichi di lavoro di produzione quando il servizio lo supporta. Per i carichi di lavoro che non possono tollerare un'interruzione a livello regionale, valutare architetture multi-regione e comprendere i compromessi in termini di coerenza dei dati. Eliminare i punti critici di guasto nascosti, come un singolo servizio di identità regionale, un singolo percorso DNS o un'unica API amministrativa da cui dipende ogni azione di ripristino.
Le applicazioni dovrebbero anche gestire gli errori in modo elegante. Ciò può significare servire contenuti memorizzati nella cache, mettere in coda le scritture non critiche, limitare i tentativi con un backoff esponenziale e un jitter, separare le operazioni del piano di controllo dal traffico del piano dati e preservare una modalità ridotta di "sola lettura" o "transazione principale" durante le interruzioni parziali. Le procedure di ripristino dovrebbero essere testate in condizioni di backlog, perché riavviare una dipendenza in un ambiente di test vuoto è molto diverso dal ripristinarla mentre milioni di richieste sono in attesa.
La lezione fondamentale derivante dai diffusi periodi di inattività del cloud
Torniamo allo scenario di Northstar Cloud. La modifica della configurazione delle 10:05 potrebbe essere l'evento scatenante, ma non ne fornisce l'intera spiegazione. L'interruzione si propaga perché la rete è condivisa, l'automazione presenta un difetto di temporizzazione, i servizi a valle dipendono dallo stesso stato, i controlli di integrità riducono la capacità, i tentativi di ripetizione aumentano il carico e i sistemi di ripristino devono elaborare un enorme arretrato.
Questo è lo schema centrale alla base di molti incidenti cloud di grave entità: il guasto iniziale è spesso di piccola entità rispetto alla catena di dipendenze che lo amplifica. Comprendere i tempi di inattività del cloud significa quindi esaminare sia la causa principale che la propagazione. Le architetture più resilienti presuppongono che i singoli componenti possano guastarsi e si concentrano sulla prevenzione di tali guasti, affinché non si trasformino in eventi a livello di sistema.