Ridurre la pressione sulla memoria di PostgreSQL in Matrix Synapse
Scopri se l'utilizzo della memoria PostgreSQL deriva da query, buffer condivisi, connessioni o operazioni di manutenzione, quindi apporta modifiche mirate e compatibili con Synapse.
Inizia verificando se i rallentamenti nelle connessioni interessano una singola stanza, un server remoto o tutte le stanze federate. Utilizza lo stato di destinazione della federazione e i log di Synapse per individuare gli errori ripetuti prima di modificare i timeout o aggiungere worker. Una connessione attraversa i confini dei server e scambia dati di autorizzazione e di stato della stanza, quindi un server remoto lento o una stanza di grandi dimensioni possono ritardare una connessione anche quando il tuo server è integro.
La specifica server-server Matrix descrive l' make_joinhandshake send_joine lo stato restituito a un server che si unisce alla rete. Ciò significa che il "ritardo di federazione" non è automaticamente un problema della coda Synapse locale. I controlli seguenti permettono di distinguere le cause più probabili.
Confronta un tentativo di connessione lento con un tentativo di connessione a una stanza federata diversa. Chiedi se altri utenti sul tuo server domestico segnalano lo stesso ritardo e annota l'ID o l'alias della stanza e i nomi dei server remoti coinvolti. Se solo una stanza è lenta, il collo di bottiglia potrebbe essere lo stato della stanza stessa o i server domestici già presenti al suo interno. Se molte stanze che coinvolgono lo stesso server remoto sono lente, verifica la raggiungibilità e lo stato dei tentativi di connessione di quella destinazione. Se le connessioni a molti server non correlati sono lente, analizza le tue risorse e il percorso di federazione in uscita.
Per il server remoto interessato, interroga l'API di amministrazione della federazione di Synapse dalla macchina su cui è in esecuzione Synapse:
curl -H "Authorization: Bearer $SYNAPSE_ADMIN_TOKEN" \
  "http://127.0.0.1:8008/_synapse/admin/v1/federation/destinations/remote.example"
Sostituisci remote.examplecon il nome del server principale e usa l'indirizzo client-listener per la tua distribuzione. Un valore diverso da zero retry_last_tse positivo retry_intervalindica che Synapse ha registrato una recente connessione non riuscita e sta aspettando prima di riprovare. Controlla i log di Synapse corrispondenti per l'errore effettivo, ad esempio errori DNS, TLS, di connessione o di risposta remota. Synapse documenta questa API di amministrazione della federazione come sperimentale e soggetta a modifiche; consulta la documentazione per la versione in esecuzione. Mantieni privata l'API di amministrazione e non incollare il suo token di accesso in una richiesta di supporto pubblica.
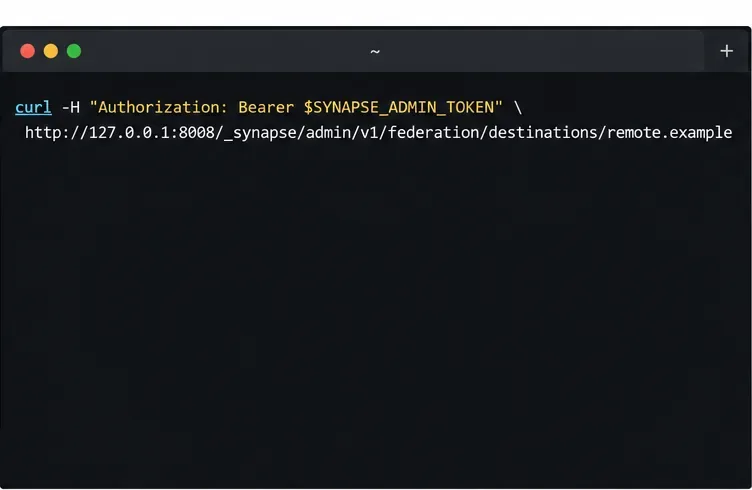
Illustrazione di una richiesta locale e autenticata di stato della destinazione. Il pannello mostra solo il comando, non la risposta in tempo reale.
Se sospetti che altri server non riescano a raggiungere il tuo homeserver, esegui il Matrix Federation Tester ufficiale per il nome del tuo server. Questo strumento verifica la rilevazione pubblica della federazione e la connettività. Tuttavia, non garantisce di per sé che una richiesta in uscita dal tuo host Synapse verso un peer specifico abbia successo, quindi confronta il suo report con i tuoi log e lo stato della destinazione.
Se Prometheus sta già raccogliendo i dati dall'endpoint delle metriche di Synapse, aggiungi i domini interessati a federation_metrics_domains, homeserver.yamlquindi ricarica o riavvia Synapse in base alla tua procedura di implementazione. Synapse può esporre le metriche di Prometheus relative all'età degli eventi persistenti delle stanze (PDU) inviati e ricevuti dai domini elencati, come descritto nel manuale di configurazione :
federation_metrics_domains:
  - matrix.org
  - remote.example
Utilizzate la serie temporale risultante per verificare se l'età degli eventi in uscita o in entrata sta aumentando. Consideratela come un indizio direzionale, non come un verdetto definitivo: la documentazione di configurazione di Synapse avverte che il ritardo può provenire sia dal server principale che dalla rete tra di essi. Una serie di eventi in uscita in ritardo su più destinazioni indica un problema con il percorso di invio o con la capacità locale; un ritardo isolato a un singolo peer richiede invece di verificare tale peer e il percorso verso di esso.
Illustrazione di un grafico concettuale sull'età della federazione; le linee non rappresentano misurazioni in tempo reale provenienti da un server Synapse.

Illustrazione dell'impostazione di Synapse utilizzata per abilitare le metriche PDU-age per i domini remoti selezionati.
Se molte operazioni risultano lente, controlla anche CPU, memoria, latenza del database e la dashboard della durata delle transazioni di Synapse. La guida di Synapse per Grafana osserva che persist_eventsla scrittura di eventi nel database può comportare un'elevata durata delle transazioni; spiega inoltre che un numero elevato di endpoint forward può aumentare il carico di lavoro per la risoluzione dello stato. Se questi parametri locali risultano elevati contemporaneamente alle join, risolvi il collo di bottiglia delle risorse o del database prima di ottimizzare i tentativi di federazione.
Aggiungere la capacità di invio solo quando il monitoraggio mostra che il lavoro in uscita è in coda su più destinazioni e il processo corrente è limitato. La documentazione attuale del worker di Synapse raccomanda di utilizzare synapse.app.generic_workerper federation_sender_instancesquesto ruolo piuttosto che creare nuove distribuzioni basate sul vecchio tipo di worker di invio dedicato.
A ciascuna destinazione in uscita viene assegnato un mittente in base a un hash del nome del server remoto. Più worker mittenti possono distribuire il traffico su più server remoti, ma le richieste verso una destinazione lenta vengono comunque mappate a un singolo worker. Pertanto, l'aggiunta di worker difficilmente risolverà un problema con un singolo peer. I nomi dei worker nella configurazione condivisa devono corrispondere ai worker in esecuzione; quando si modifica l'elenco delle istanze mittenti, arrestare e riavviare tutti i mittenti della federazione contemporaneamente in modo che utilizzino la stessa configurazione.
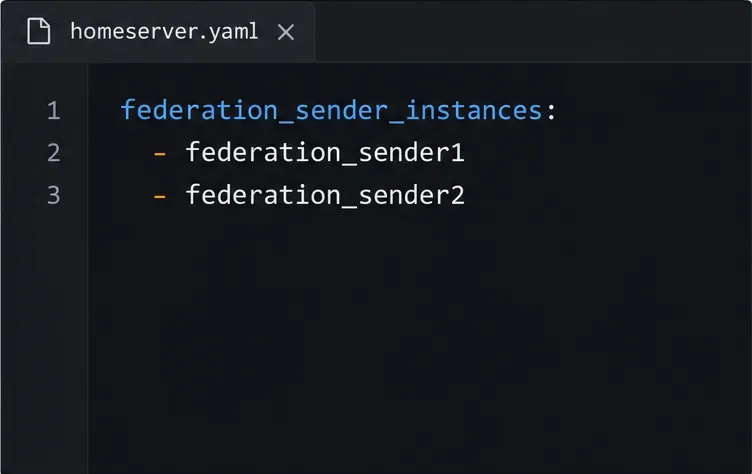
Illustrazione dell'elenco federation_sender_instances; ogni worker denominato deve esistere nel deployment.
Reimposta il timer di ripetizione di una destinazione solo dopo aver corretto un problema di connettività temporaneo e aver verificato che Synapse abbia contrassegnato tale destinazione come non funzionante. L'API di amministrazione fornisce un POST /_synapse/admin/v1/federation/destinations/<destination>/reset_connectionendpoint; la sua richiesta viene eseguita in background, quindi un codice HTTP 200 immediato non significa che la federazione sia stata ripristinata. Questo endpoint è inoltre documentato come sperimentale.
Non sollevare questa questione federation.client_timeoutcome prima risposta. Il manuale di configurazione attuale prevede un valore predefinito di 60 secondi. Un timeout più lungo concede a un server remoto lento più tempo per rispondere; tuttavia, non velocizza né il server né la rete e può comportare tempi di attesa più lunghi per le richieste di adesione. Modificare questo valore solo se i log mostrano che le richieste di federazione legittime superano il valore corrente e dopo aver verificato la capacità del server.
Riprova ad accedere alla stessa stanza e confronta il risultato con quello di una stanza federata diversa. Verifica che la destinazione interessata non mostri più un intervallo di tentativi crescente, che i log mostrino richieste di federazione riuscite e che le metriche PDU-age configurate smettano di aumentare. Se solo una stanza rimane lenta mentre le altre destinazioni funzionano correttamente, condividi l'ID della stanza, il server remoto coinvolto, l'intervallo di tempo e le righe di errore oscurate con gli amministratori della stanza o con l'assistenza Synapse. Evita di inviare token di accesso o intestazioni di autorizzazione complete.
Scopri se l'utilizzo della memoria PostgreSQL deriva da query, buffer condivisi, connessioni o operazioni di manutenzione, quindi apporta modifiche mirate e compatibili con Synapse.
Traccia le connessioni lente alle stanze Matrix verso un homeserver remoto, il backoff della federazione, il caricamento del database locale o una coda di invio in uscita prima di modificare le impostazioni di Synapse.
Impedisci la creazione di account aperti su un server Synapse self-hosted oppure mantieni le registrazioni accessibili solo su invito con token di registrazione a utilizzo limitato.
Clear Element offre un sistema di avviso per sessioni non verificate utilizzando un dispositivo attendibile o una chiave di ripristino, con controlli che proteggono la cronologia delle chat crittografate.
Distingui i conflitti di blocco del database dai blocchi WebDAV scaduti, quindi scegli e configura la soluzione ownCloud 10 più adatta.
Individua le cause di una schermata web ownCloud vuota, come la cache del browser, la mancanza di risorse web, errori di servizio o impostazioni URL del proxy inverso, tramite controlli mirati.
Imposta il limite di memoria PHP web di ownCloud, riavvia il servizio corrispondente e verifica il valore attivo senza confonderlo con le impostazioni della CLI o i limiti di caricamento.
Scopri se MySQL, PHP, le impostazioni dei socket o i permessi del database stanno bloccando ownCloud 10, quindi verifica una soluzione sicura.
Rendi obbligatoria la scadenza dei link pubblici in ownCloud Classic, imposta una durata massima e verifica le condivisioni esistenti che potrebbero richiedere una pulizia separata.
Abilita TOTP tramite Keycloak, registra gli utenti in modo sicuro e scopri quando si applicano le impostazioni MFA a livello di percorso di Infinite Scale.


