Home
» Tecnologia
»
Interruzione di servizio di Salesforce del 2025: una retrospettiva sulle principali interruzioni.
Interruzione di servizio di Salesforce del 2025: una retrospettiva sulle principali interruzioni.
La conclusione più importante che si può trarre dall'analisi dei disservizi di Salesforce per il 2025 è che non si è verificato un singolo "disastro globale" che abbia definito l'anno. Al contrario, i clienti hanno sperimentato diverse tipologie di interruzioni: un'interruzione generalizzata del servizio a febbraio, problemi di autenticazione su più piattaforme cloud a giugno, un grave incidente sulla piattaforma Heroku causato da un aggiornamento non intenzionale del fornitore, un evento di rete nel data center di Indianapolis e, successivamente, incidenti limitati a specifiche istanze o funzionalità. Questa distinzione è importante perché la risposta più appropriata dipende da cosa non ha funzionato.
Se gli utenti non riescono ad accedere, un aggiornamento del browser non risolverà il problema. Se la pagina di stato pubblica è in ritardo, anche un sistema di monitoraggio generico delle interruzioni potrebbe risultare incompleto. Se Salesforce è disponibile ma una coda di integrazione è bloccata, il CRM stesso potrebbe apparire funzionante mentre i processi aziendali continuano a non funzionare. La lezione pratica del 2025 è quella di combinare notifiche di stato specifiche per il tenant, monitoraggio indipendente, procedure manuali testate e un controllo di ripristino per i sistemi a valle.
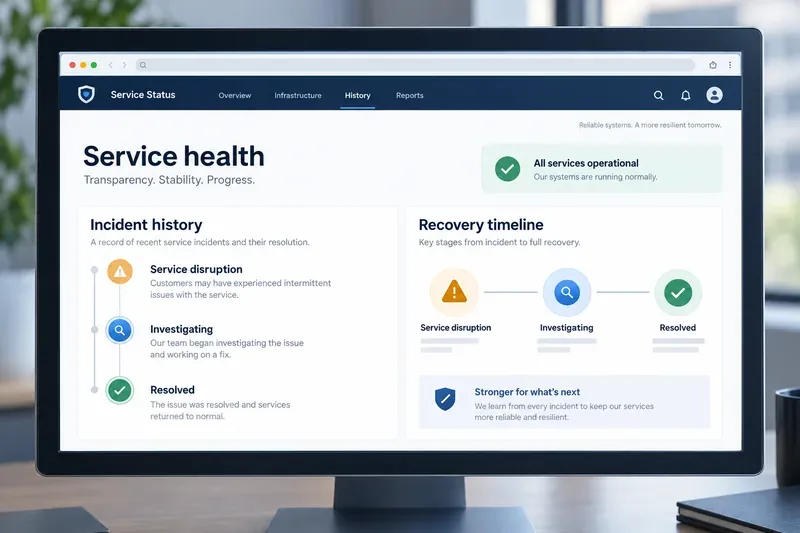
Una dashboard generica sullo stato del servizio mostra le fasi che i team esaminano durante la ricostruzione della cronologia di un'interruzione; si tratta di una rappresentazione concettuale, non di uno screenshot reale di Salesforce.
Quali sono state le principali innovazioni dirompenti di Salesforce nel 2025?
I seguenti incidenti sono utili a fini retrospettivi perché mostrano diverse modalità di errore. Non si intende affermare che ogni evento di stato di Salesforce del 2025 sia elencato qui.
Data
Interruzione
Ciò che emerge dai dati
Perché è importante
7 febbraio
Interruzione del servizio
Secondo il verbale ufficiale dell'incidente, l'interruzione si è conclusa alle 11:21 UTC ed è durata circa 2 ore e 20 minuti.
Un evento di servizio di ampia portata può influire sul normale funzionamento di Salesforce anche quando la causa principale non viene resa pubblica.
10 giugno
Errori di autenticazione tra cloud
Salesforce ha segnalato un impatto sui servizi di autenticazione per Heroku, Commerce, Marketing Cloud e i servizi Salesforce.
Le dipendenze relative all'accesso e all'identità possono causare un'interruzione del servizio tra diversi prodotti, anche se ciascun prodotto non presenta lo stesso problema tecnico.
10 giugno
Disruption della piattaforma Heroku
Heroku ha successivamente attribuito l'incidente a un aggiornamento di sistema non intenzionale applicato all'infrastruttura di produzione da un fornitore. Anche il sito di stato di Heroku è stato interessato.
Il canale di comunicazione può diventare parte integrante dell'incidente, rendendo essenziali percorsi di notifica indipendenti.
18 giugno
interruzione della rete del data center di Indianapolis
Salesforce ha segnalato che un guasto al sistema di raffreddamento del data center di Indianapolis ha interessato gli Stack 1 e 6.
Gli eventi che interessano le infrastrutture fisiche possono essere più circoscritti rispetto a un'interruzione globale, ma comunque gravi per i casi specifici coinvolti.
1 novembre
Interruzione del servizio principale a livello di istanza
Il registro ufficiale degli incidenti identifica IND76 come istanza interessata e registra l'evento come risolto.
Le verifiche specifiche per ogni singola istanza sono più utili rispetto al semplice affidarsi a report generici del tipo "Salesforce è inattivo?".
31 dicembre
Degrado delle prestazioni della messaggistica WhatsApp
Salesforce ha segnalato un impatto sulle prestazioni della funzionalità di messaggistica WhatsApp in diversi casi e ha successivamente confermato il ripristino alle 16:56 UTC.
Una funzionalità può risultare compromessa mentre il resto del CRM rimane utilizzabile.
Gli incidenti del 10 giugno rivelano due diversi livelli di fallimento
Il 10 giugno è una data particolarmente importante perché l'espressione "interruzione del servizio Salesforce" può descrivere più di un evento. Il registro di sicurezza di Salesforce segnalava errori di autenticazione a più fattori che interessavano diverse piattaforme cloud. Il successivo rapporto di Heroku sulle azioni correttive descriveva un'interruzione del servizio della piattaforma iniziata alle 06:00 UTC e causata da un aggiornamento di sistema non intenzionale applicato all'infrastruttura di produzione da un fornitore.
Heroku ha inoltre riconosciuto che il suo sito di stato è stato interessato dal problema. Secondo l' aggiornamento sulle azioni correttive di Heroku , le carenze nella progettazione della pagina di stato e la latenza dell'API hanno causato dei timeout, e la pagina poteva apparire come se non mostrasse incidenti attivi. Heroku ha affermato di aver risposto con misure di controllo che includono l'interruzione permanente degli aggiornamenti automatici del sistema operativo dei fornitori, verifiche delle immagini, monitoraggio aggiuntivo, contenuti di stato memorizzati nella cache, pianificazione indipendente della comunicazione e procedure di risposta agli incidenti più rigorose.
Questa è una distinzione importante per gli amministratori. Una pagina di stato non è il servizio in sé, ma viene utilizzata dai clienti per decidere se attendere, effettuare un failover, aprire una richiesta di assistenza o comunicare con i propri utenti. Se il canale di stato condivide troppa infrastruttura con la piattaforma interessata, potrebbe non fornire una visualizzazione affidabile nel momento in cui è più necessaria.
Che lezione ha insegnato il record del 2025 ai clienti di Salesforce?
1. L'autenticazione merita un piano di continuità dedicato.
Un team potrebbe avere dati applicativi corretti eppure non essere in grado di lavorare se l'accesso, l'autenticazione a più fattori o un percorso di identità connesso falliscono. Questo è particolarmente importante per le aziende che utilizzano Salesforce, Heroku, Commerce e Marketing Cloud insieme. Documentate quali utenti necessitano di accedere a quali sistemi, identificate i contatti di emergenza che possono ricevere aggiornamenti dai fornitori e definite quali attività possono proseguire anche in assenza di un accesso riuscito.
Per un piccolo team di vendita, ciò potrebbe significare un elenco di chiamate manuale di breve durata e un registro degli incidenti condiviso. Per un contact center o un'azienda del settore sanitario, potrebbe essere necessaria una procedura formale per i periodi di inattività, esportazioni di sola lettura approvate e una struttura di escalation collaudata. La portata del piano di ripiego dovrebbe essere commisurata alle conseguenze aziendali del blocco dell'accesso.
2. Una pagina di stato generica non è sufficiente
La documentazione ufficiale di Salesforce spiega che Trust Status fornisce informazioni su disponibilità e prestazioni, mentre le visualizzazioni più recenti di My Trust Center sono progettate in base ai tenant e ai prodotti supportati. Il concetto operativo è semplice: conoscere l'identificativo dell'istanza o del tenant prima che si verifichi un incidente.
Salesforce fornisce anche istruzioni per l'iscrizione ai messaggi e alle notifiche di My Trust Center . Configura le notifiche per le persone che devono intervenire, non solo per l'amministratore che ha creato l'organizzazione. Mantieni un canale indipendente, come una pagina di stato interna o un gruppo di messaggistica approvato, in modo che la tua azienda possa comunicare anche se il sito di stato del fornitore è lento o non disponibile.
3. Il recupero è più che visualizzare la schermata di accesso.
Anche quando Salesforce segnala il ripristino dei servizi, l'incidente potrebbe comunque avere ripercussioni sull'attività aziendale. Una richiesta API ritardata potrebbe essere ritentata due volte, un messaggio in coda potrebbe arrivare in ritardo o un'implementazione non riuscita potrebbe causare la desincronizzazione dei record. Dopo il ripristino, è necessario verificare i flussi di lavoro più importanti: autenticazione, chiamate API, processi pianificati, code di integrazione, invio di e-mail o messaggi, creazione di record e aggiornamento dei report.
Ad esempio, immaginiamo un team di supporto di medie dimensioni i cui agenti utilizzano i casi di Salesforce, mentre un sistema di e-commerce separato invia aggiornamenti tramite un'integrazione. Se Salesforce torna disponibile alle 10:00, ma la coda di integrazione contiene messaggi non elaborati relativi al periodo di interruzione del servizio, il team non dovrebbe chiudere l'incidente solo perché il browser si carica. Il test corretto consiste nel verificare se i nuovi aggiornamenti e quelli precedentemente non elaborati vengono elaborati correttamente attraverso l'intero flusso di lavoro senza duplicazioni.
Quali misure di continuità operativa sono più adatte alla vostra organizzazione?
Condizioni aziendali
Minimo pratico
Quando aggiungere altro
Squadra piccola; una breve interruzione è tollerabile.
Iscriviti alle notifiche Trust pertinenti, annota l'identificativo dell'istanza e tieni un breve elenco di controllo per le attività manuali.
Aggiungi le esportazioni e i test di ripristino se la cronologia dei clienti o i registri di conformità sono fondamentali.
Le operazioni di fatturato, contact center o assistenza clienti dipendono da Salesforce tutto il giorno.
Utilizzare un sistema di monitoraggio indipendente, una procedura per i periodi di inattività, controlli di ritentativo dell'integrazione e un responsabile designato per la gestione degli incidenti.
Prima di un'interruzione effettiva, testare il sistema di failover o i canali di ricezione alternativi durante l'orario di lavoro.
Salesforce è collegato a Heroku o a diverse piattaforme cloud.
Monitorare separatamente la fonte dello stato di ciascun prodotto e documentare le dipendenze di autenticazione.
Eseguire esercitazioni di ripristino congiunte che testino insieme l'accesso, le API, le code e le comunicazioni con i clienti.
Dati regolamentati o di alto valore
Utilizzare un piano di backup e conservazione approvato, controlli di accesso, registri di controllo e un manuale di ripristino.
Fai esaminare il manuale operativo dal personale addetto alla sicurezza, all'ufficio legale, alla conformità e dai titolari dell'azienda.
Come utilizzare questa retrospettiva nel 2026 e oltre
Iniziate con una mappa delle dipendenze di una pagina. Annotate l'istanza o il tenant di Salesforce, il provider di identità, i cloud connessi, le integrazioni critiche, gli abbonamenti allo stato e il processo manuale utilizzato durante un'interruzione. Quindi definite un controllo oggettivo del ripristino per ogni flusso di lavoro importante. "Salesforce è tornato online" è troppo vago; "nuovi casi, messaggi in uscita e aggiornamenti degli ordini vengono elaborati senza duplicati" è un controllo verificabile.
Infine, è necessario esaminare le modifiche che possono influire sulla disponibilità: aggiornamenti dei fornitori, modifiche al sistema operativo, nuove versioni, modifiche alla configurazione e migrazioni di istanze. L'incidente di Heroku di giugno dimostra perché le modifiche non presidiate richiedono controlli rigorosi e perché la comunicazione dello stato necessita di una propria resilienza. L'evento del 18 giugno mostra perché la capacità fisica e le dipendenze dai data center sono ancora importanti in un servizio cloud. Il degrado delle funzionalità di dicembre dimostra perché i team dovrebbero monitorare le funzioni che effettivamente utilizzano, non solo la disponibilità di alto livello della piattaforma.
La risposta più appropriata è quindi condizionata. Una piccola organizzazione potrebbe aver bisogno di notifiche e di una chiara checklist manuale. Un'azienda che non può sospendere le vendite o l'assistenza necessita di monitoraggio indipendente, ripristino basato sulle code e un processo collaudato per la gestione dei tempi di inattività. Un'organizzazione altamente regolamentata necessita di ripristino testato, prove documentali e governance. Il record di interruzioni di Salesforce del 2025 conferma una conclusione costante: la resilienza si costruisce attorno alla catena di dipendenza del cliente, non attorno a un singolo indicatore di stato verde.
Fonti e ambito di applicazione
Questa analisi retrospettiva si basa sui record degli incidenti di Salesforce Trust e sulla documentazione di Salesforce o Heroku disponibile al momento della stesura. Le pagine relative agli incidenti possono essere aggiornate dopo la risoluzione e la copertura dei prodotti Salesforce varia tra Stato di affidabilità e Centro assistenza clienti. Laddove Salesforce non abbia pubblicato un'analisi dettagliata delle cause principali, questo articolo non ne deduce alcuna.