Home
» Tecnologia
»
Come l'intelligenza artificiale incarnata sta trasformando la robotica umanoide di nuova generazione
Come l'intelligenza artificiale incarnata sta trasformando la robotica umanoide di nuova generazione
I robot umanoidi possono apparire straordinariamente capaci durante una breve dimostrazione, ma faticare comunque quando l'illuminazione cambia, un oggetto viene spostato di pochi centimetri, un cassetto si blocca o un'attività richiede più tempo rispetto alla sequenza utilizzata durante l'addestramento. Questo divario tra una dimostrazione impeccabile e un funzionamento affidabile nel mondo reale è il problema centrale che la robotica umanoide di nuova generazione sta cercando di risolvere.
La trasformazione in atto sta portando dal passaggio da robot che si limitano a ripetere movimenti programmati a robot in grado di percepire, ragionare, pianificare e agire attraverso un corpo fisico. Questo approccio è comunemente chiamato intelligenza artificiale incarnata . In termini pratici, il robot non si limita a eseguire un modello di intelligenza artificiale; la sua intelligenza è legata a telecamere, sensori di forza, posizioni delle articolazioni, mani, gambe e all'ambiente circostante in continua evoluzione.
A settembre 2026, diversi importanti programmi di robotica si stavano muovendo in questa direzione. Google DeepMind ha presentato Gemini Robotics 2 a luglio 2026, con controllo di tutto il corpo e ragionamento incarnato; GR00T 1.7 di NVIDIA fornisce un modello di base aperto visione-linguaggio-azione e un flusso di lavoro di addestramento end-to-end; Figure afferma che Helix 02 estende il suo controllo appreso dalla parte superiore del corpo alla locomozione e manipolazione di tutto il corpo; e Boston Dynamics sta combinando comportamenti appresi, apprendimento per rinforzo e ricerca sui modelli di base con la sua piattaforma di produzione Atlas. Questi sviluppi sono importanti, ma dovrebbero essere interpretati come la prova di rapidi progressi, non come la dimostrazione che gli umanoidi per uso generale siano pronti per ogni luogo di lavoro o abitazione.
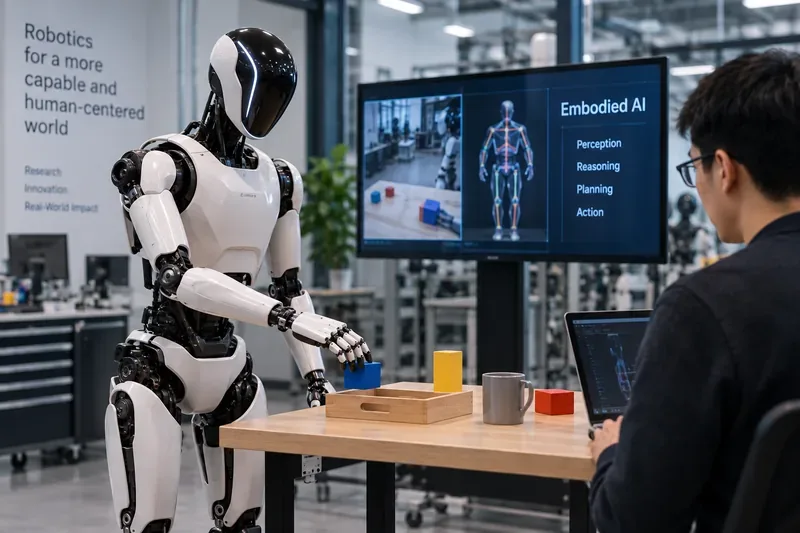
Un robot umanoide lavora a un banco di prova mentre un ingegnere monitora il ciclo percezione-azione che i sistemi di intelligenza artificiale incarnata cercano di chiudere in tempo reale.
Perché l'automazione robotica tradizionale non funziona negli ambienti umani
I robot industriali convenzionali sono estremamente efficaci quando l'ambiente circostante è controllato. Un braccio fisso può ripetere lo stesso movimento di saldatura, posizionamento o assemblaggio migliaia di volte perché la posizione dell'oggetto, gli utensili, la protezione antinfortunistica e la sequenza delle operazioni sono stati progettati attorno al robot.
I robot umanoidi sono progettati per ambienti operativi più complessi: spazi costruiti per le persone. Scaffali, porte, contenitori, utensili, scale, postazioni di lavoro e componenti possono variare. Il robot potrebbe dover camminare, raggiungere oggetti, mantenere l'equilibrio, manipolare, recuperare da una presa errata e comprendere un comando vocale senza che un tecnico debba riscrivere il programma di movimento ogni volta che si verifica una modifica.
Ciò crea quattro problemi interconnessi:
Incertezza percettiva: il robot deve riconoscere oggetti, superfici, persone, spazio libero e stato del compito in condizioni mutevoli.
Ragionamento a lungo termine: un compito utile spesso contiene molti passaggi interdipendenti e un errore in un passaggio può invalidare il resto del piano.
Coordinazione di tutto il corpo: camminare e manipolare oggetti sono attività interconnesse. Allungarsi di più modifica l'equilibrio; sollevare un carico modifica le forze articolari e la stabilità.
Scarsità di dati: raccogliere dimostrazioni robotiche di alta qualità nel mondo fisico è costoso e lento rispetto alla raccolta di testi o immagini per l'intelligenza artificiale su scala internet.
L'intelligenza artificiale incarnata sta rivoluzionando lo sviluppo degli umanoidi perché affronta questi problemi come un sistema di apprendimento interconnesso, anziché trattare la percezione, la pianificazione e il movimento come script isolati.
1. Inizia con un ciclo di conversione percezione-azione più efficace
Il miglioramento concettuale più semplice è anche il più fondamentale: il robot deve osservare continuamente cosa è successo dopo aver agito. Una macchina programmata può eseguire "sposta la mano alle coordinate X, Y, Z". Un sistema incarnato, invece, cerca di rispondere a un ciclo più complesso: "Dov'è l'oggetto ora? L'ho afferrato? Si è mosso? Cosa devo fare adesso?".
I moderni modelli visione-linguaggio-azione , solitamente abbreviati in VLA , collegano l'input visivo e le istruzioni in linguaggio naturale alle azioni del robot. Google DeepMind descrive Gemini Robotics 2 come un VLA che converte visione e linguaggio in controllo motorio. NVIDIA descrive GR00T 1.7 come un VLA cross-embodiment che accetta input multimodali come linguaggio, immagini e stato del robot e produce azioni.
Questo è importante perché lo stesso modello può potenzialmente riutilizzare concetti generali in molteplici attività. "Prendi la scatola blu e mettila nel vassoio" non deve più significare una traiettoria predefinita legata a una specifica disposizione del tavolo.
2. Sostituire le politiche monotasking con modelli di base riutilizzabili
Il passo successivo consiste nel ridurre la quantità di comportamento che deve essere appreso da zero. Un modello di base per robot mira a codificare informazioni a priori riutilizzabili su oggetti, linguaggio, movimento e manipolazione prima che uno sviluppatore lo specializzi per un particolare umanoide o flusso di lavoro.
NVIDIA afferma che GR00T 1.7 è stato pre-addestrato su circa 32.000 ore di dati reali di dimostrazione e dati umani egocentrici, oltre a circa 8.000 ore di simulazioni di implementazione e dimostrazioni. Gli sviluppatori possono quindi addestrare ulteriormente il modello di base per una specifica implementazione e attività, anziché partire da una policy vuota.
Il miglioramento qualitativo atteso non si limita al semplice "il robot sa di più". Il risultato più utile è la generalizzazione : una politica dovrebbe continuare a funzionare anche quando la posizione dell'oggetto, il punto di vista, lo sfondo o la formulazione del compito cambiano entro limiti ragionevoli.
Un buon indicatore dell'efficacia di questo approccio si ha quando un team riesce ad aggiungere un nuovo oggetto, una nuova configurazione della scena o una nuova istruzione con una minore necessità di riqualificazione specifica rispetto a prima. Un segnale di allarme si ha quando ogni nuova variante richiede ancora una procedura separata, un ambiente attentamente predisposto o una routine di ripristino manuale.
3. Utilizzare la simulazione per scalare l'esperienza senza danneggiare l'hardware.
I robot fisici sono dispositivi di addestramento costosi. I motori si surriscaldano, le mani si usurano, le batterie si scaricano, gli oggetti si rompono e una caduta può interrompere lo sviluppo per ore o giorni. La simulazione risolve questi problemi consentendo di testare in parallelo diverse varianti delle politiche prima di procedere alla verifica sull'hardware.
Boston Dynamics descrive l'addestramento dei comportamenti di Atlas tramite apprendimento per rinforzo in simulazione, per poi passare all'hardware reale e iterare a partire dai risultati ottenuti nel mondo reale. Il flusso di lavoro GR00T di NVIDIA include in modo simile la configurazione della simulazione, la raccolta dei dati di teleoperazione, l'addestramento delle policy, la valutazione e l'implementazione.
La frase chiave è "dalla simulazione alla realtà" : trasferire ciò che un modello ha appreso in simulazione a un robot fisico. La simulazione è preziosa, ma non è la realtà. Attrito, contatto, rumore dei sensori, comportamento dei cavi, conformabilità dei materiali e imprevedibilità umana sono difficili da modellare alla perfezione.
I team dovrebbero quindi considerare la simulazione come un moltiplicatore di forze, non come un sostituto della validazione hardware. Una politica che appare perfetta in simulazione ma che crolla in presenza di piccole variazioni nel mondo reale non ha risolto il problema dell'implementazione.
4. Passare dalle abilità delle braccia all'intelligenza del corpo intero
I robot umanoidi si differenziano realmente dai bracci robotici statici quando la locomozione e la manipolazione vengono risolte simultaneamente. Una persona che apre una porta pesante sposta naturalmente il peso, cambia postura, ruota il busto e regola la presa. I robot umanoidi devono coordinare interazioni simili tra numerose articolazioni, mantenendo al contempo la stabilità.
Figure ha annunciato Helix 02 nel gennaio 2026 , affermando che il suo sistema collega vista, tatto e propriocezione all'attuazione di tutto il corpo in una rete visuomotoria unificata. L'azienda ha dimostrato un'attività autonoma di lavaggio della lavastoviglie che combinava camminata, equilibrio e manipolazione per diversi minuti. Si tratta di una dimostrazione riportata dall'azienda, non di un benchmark indipendente, ma illustra chiaramente la direzione: l'autonomia di tutto il corpo sta sostituendo la vecchia distinzione tra "prima la navigazione" e "secondo il compito del braccio".
Anche il robot Gemini Robotics 2 di Google DeepMind pone l'accento sul controllo completo del corpo umanoide, inclusi i movimenti coordinati dai piedi alla punta delle dita. L'obiettivo ingegneristico più ampio non è quello di far muovere ogni umanoide come una persona, ma di permettere al robot di scegliere movimenti corporei stabili ed efficienti che consentano di svolgere il compito in sicurezza.
5. Aggiungere un livello di ragionamento per attività lunghe e a più fasi
Un VLA (Virtual Logic Analyzer) può gestire azioni locali basate su sensori, ma i compiti più lunghi richiedono un ragionamento di livello superiore. Si pensi, ad esempio, a "sgomberare questo banco da lavoro, riporre gli attrezzi nei cassetti etichettati, gettare via gli imballaggi e segnalare eventuali danni". Il robot deve identificare le sotto-attività, tenere traccia di quelle completate, riconoscere gli errori e modificare il piano quando l'ambiente non corrisponde alle aspettative.
Google DeepMind separa questo ruolo in Gemini Robotics ER 2, un modello di ragionamento incarnato progettato per la comprensione spaziale, la pianificazione delle attività, l'orchestrazione degli strumenti e il rilevamento del successo. L'azienda descrive una gerarchia in cui un modello di ragionamento di alto livello può delegare l'esecuzione motoria a un VLA di livello inferiore.
Questa architettura a strati è importante perché il controllo motorio ad alta frequenza e la pianificazione lenta e ponderata delle attività hanno esigenze diverse. Una mano umanoide potrebbe aver bisogno di aggiornamenti rapidi dei comandi, mentre un sistema di pianificazione potrebbe dover riconsiderare la successiva sotto-attività solo dopo un evento significativo.
Per i team di produzione, il test di qualità consiste nella capacità del sistema di riprendersi dagli errori più comuni. Un robot in grado di eseguire otto passaggi solo se tutti i precedenti sono andati a buon fine è ancora fragile. Un sistema più robusto è in grado di rilevare lo slittamento del pezzo, riacquisirlo e proseguire senza dover riavviare l'intera operazione.
6. Offrire maggiore intelligenza sul dispositivo
Il ragionamento in cloud può fornire modelli complessi e calcoli intensivi, ma un robot fisico non può sempre attendere un round trip di rete prima di reagire. Equilibrio, prevenzione delle collisioni, correzione della presa e molti cicli di controllo richiedono una latenza bassa e prevedibile.
Ecco perché i modelli robotici on-device e gli acceleratori edge sono importanti. Il lavoro di Google DeepMind su Gemini Robotics On-Device si concentra sull'esecuzione locale di intelligenza manipolativa generica, mentre lo stack umanoide di NVIDIA supporta l'implementazione tramite edge computing come Jetson Thor.
L'architettura più probabile per umanoidi capaci è ibrida, piuttosto che puramente locale o basata esclusivamente sul cloud: percezione e controllo rapidi in prossimità del robot, con attività più complesse come la pianificazione, l'analisi della flotta o gli aggiornamenti del modello eseguiti su infrastrutture più potenti quando la latenza e la connettività lo consentono.
7. Trasformare l'esperienza di un singolo robot in apprendimento per l'intera flotta
Il vantaggio commerciale dell'intelligenza artificiale incarnata diventa più rilevante quando le competenze possono essere riutilizzate da molti robot. L'automazione tradizionale spesso si basa sulla copia dello stesso programma in celle identiche. Il comportamento umanoide appreso può potenzialmente essere scalato distribuendo una politica migliorata e utilizzando i dati della flotta per scoprire nuovi casi di errore.
Boston Dynamics afferma che i comportamenti appresi da Atlas possono essere riutilizzati su diverse flotte e sta sviluppando Atlas per attività industriali come la sequenza dei pezzi e la movimentazione dei materiali. Il suo programma di prodotti per il 2026 include anche la collaborazione con Google DeepMind sui modelli di base di Gemini Robotics. Consulta la panoramica sull'evoluzione di Atlas di Boston Dynamics e l' annuncio della partnership con Google DeepMind .
L'apprendimento a livello di flotta introduce un nuovo requisito: la disciplina nella valutazione. Un aggiornamento delle policy che migliora un'attività ma crea problemi altrove non dovrebbe essere implementato su larga scala senza test di regressione.
Quali cambiamenti introduce l'intelligenza artificiale incarnata nella robotica umanoide?
Approccio precedente
Direzione dell'IA incarnata
Risultato da ricercare
Script e coordinate fissi
Controllo visivo e propriocettivo a circuito chiuso
Recupero quando gli oggetti si muovono o le prese falliscono
Una politica per ogni attività
Modelli di base e post-formazione
Adattamento più rapido ai compiti correlati
Camminare e manipolare separatamente
Controllo appreso di tutto il corpo
Manovrabilità locomotiva stabile per compiti di lunga durata
Piccoli set di dati fisici
Dati reali, simulazione e teleoperazione
Copertura più ampia dei casi limite
Script di attività locali
Ragionamento gerarchico più esecuzione VLA
Sequenze più lunghe con autocorrezione
Regolazione di un singolo robot
Apprendimento inter-incarnazione e di flotta
Competenze riutilizzabili su diverse piattaforme e implementazioni.
Dove la rivoluzione ha ancora dei limiti
I progressi sono reali, ma diversi limiti restano facili da sottovalutare.
La sicurezza è più difficile del raggiungimento degli obiettivi prefissati.
Un modello può ottenere un buon punteggio nelle valutazioni di robotica pur risultando inadatto a un impiego in contesti critici per la sicurezza. La scheda tecnica del modello Gemini Robotics ER 2 di Google DeepMind avverte esplicitamente gli utenti di usare discrezione in ambienti di produzione, commerciali o pubblici e specifica che i modelli robotici non devono essere utilizzati per applicazioni critiche per la sicurezza in cui un malfunzionamento potrebbe prevedibilmente causare lesioni, morte o danni materiali.
La destrezza rimane irregolare
Scegliere le scatole è molto più semplice che manipolare cavi flessibili, oggetti bagnati, imballaggi deformabili, elementi di fissaggio stretti o gruppi di attrezzi intricati. Le dimostrazioni efficaci dovrebbero quindi essere giudicate in base alla varietà e alla ripetibilità delle attività, non solo alla loro complessità visiva.
L'affidabilità a lungo termine aggrava gli errori
Anche se ogni singola azione è altamente affidabile ma non quasi perfetta, un'attività che contiene decine o centinaia di azioni dipendenti può comunque fallire frequentemente. Ecco perché il rilevamento del successo, il ripristino e la gestione delle eccezioni sono importanti quanto la pura accuratezza delle azioni.
L'hardware rimane parte del problema dell'intelligenza
I modelli più avanzati non possono compensare indefinitamente la debolezza delle mani, la scarsa precisione dei sensori, il surriscaldamento degli attuatori, la durata limitata della batteria, i giochi meccanici o la difficoltà di manutenzione. L'utilità dei robot umanoidi dipende dal miglioramento congiunto di software e hardware.
Come valutare se un sistema umanoide sta effettivamente migliorando
Il modo migliore per valutare l'IA incarnata è andare oltre la qualità della demo e chiedersi se il robot diventi più utile in presenza di variazioni. Un'autovalutazione pratica può includere le seguenti domande:
Successo del compito: il robot completa l'intero compito, non solo la fase più semplice?
Ripetibilità: Il risultato si verifica con successo in numerose prove, anziché solo in un video selezionato?
Generalizzazione: è in grado di gestire nuove posizioni degli oggetti, illuminazione, punti di vista e oggetti simili non ancora visti?
Ripristino: è in grado di rilevare e riparare i guasti più comuni senza bisogno di un intervento umano?
Tempo di insegnamento: quanta dimostrazione, etichettatura, programmazione o messa a punto sono necessarie per un nuovo compito?
Stabilità di tutto il corpo: è in grado di muoversi agevolmente durante la camminata, le curve, i piegamenti o il trasporto di carichi senza transizioni fragili?
Latenza: il ciclo di controllo rimane reattivo in condizioni di rete e di calcolo realistiche?
Sicurezza: la prossimità umana, le collisioni, la forza, lo spazio di lavoro e i comportamenti di arresto di emergenza vengono testati indipendentemente dal successo del compito?
Trasferimento della flotta: è possibile applicare una competenza appresa a più robot con prestazioni prevedibili?
Valore operativo: il sistema riduce sufficientemente gli interventi, i tempi di inattività, il carico ergonomico o la complessità dei processi da giustificarne il costo?
Se i progressi si manifestano solo in dimostrazioni attentamente pianificate ma non in queste misurazioni, il team dovrebbe cambiare approccio, spesso restringendo il compito, raccogliendo dati più precisi sui guasti, migliorando la copertura della simulazione, rafforzando il controllo di basso livello o aggiungendo livelli espliciti di sicurezza e ripristino.
Il cambiamento più importante non è la forma umanoide
L'intelligenza artificiale incarnata sta rivoluzionando la robotica umanoide perché cambia il modo in cui i robot acquisiscono e riutilizzano le competenze. Il cambiamento chiave consiste nel passare dalla programmazione di ogni singolo movimento all'addestramento di sistemi in grado di connettere percezione, linguaggio, stato fisico, ragionamento e azione in un ciclo continuo.
La prova più convincente nel 2026 non è che gli umanoidi siano diventati universalmente versatili. È piuttosto che diverse tecnologie precedentemente separate – modelli di base multimodali, politiche VLA, apprendimento per rinforzo, simulazione, hardware destreggiato, inferenza on-device e implementazione di flotte – stanno convergendo in stack robotici coerenti.
Questa convergenza rende i robot umanoidi più adattabili e più facili da addestrare, ma un'autonomia affidabile richiede comunque un'attenta valutazione nell'ambiente specifico in cui il robot opererà. La prossima generazione verrà giudicata meno in base alla capacità di un robot di eseguire una dimostrazione sorprendente e più in base alla sua capacità di ripetere in sicurezza compiti utili, di rimediare a errori comuni e di migliorare senza una costante riprogrammazione manuale.