Home
» Come fare
»
Ubuntu Server Booting into Emergency Mode: A Step-by-Step Rescue Guide
Ubuntu Server Booting into Emergency Mode: A Step-by-Step Rescue Guide
Illustrative scenario: Casey maintains a hypothetical Ubuntu Server VM that drops into emergency mode after a reboot, shortly after an optional data-volume mount was added to /etc/fstab. Casey has console access but no SSH session. The mount change is a lead, not a proven cause: emergency mode can follow several boot failures, so Casey checks the current machine’s logs before changing anything. The terminal panels below show representative layouts and placeholder output, not a real repair or test.
What emergency mode means
On an Ubuntu Server installation using systemd, emergency.target starts a minimal shell on the main console. It is more limited than rescue.target, which brings up the base system and system mounts with only essential services. Depending on the path into emergency mode, the root filesystem may already be mounted read-only or read-write. Check it instead of assuming either state. See the upstream systemd special-target documentation.
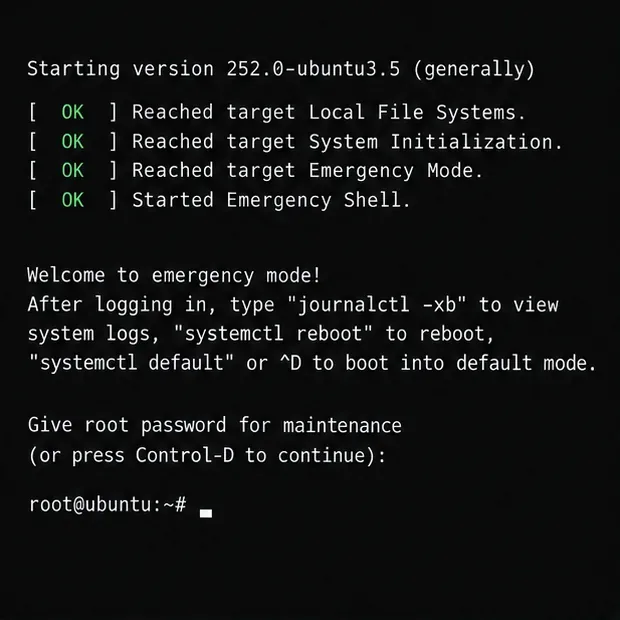
First distinguish the prompt. A systemd emergency shell typically says “Welcome to emergency mode!” and may ask for the root password for maintenance. A BusyBox prompt such as (initramfs) means boot has not yet switched to the installed root filesystem; a grub> or grub rescue> prompt is a bootloader problem. These require different recovery paths. If the root account is locked or the server is remote, use the hosting provider’s serial/VNC console or rescue environment; SSH usually is not available at this stage. Do not press Ctrl+D to continue until you understand and fix the reported failure.
Step-by-step rescue
1. Keep console access and record the exact failure
Stay in the emergency console. Note the last failed mount or service name and any device path or UUID printed above the prompt. Casey’s recent fstab edit is worth checking, but do not comment out every failing line or run a repair command based only on the word “emergency.” If the system is a virtual machine, keep the provider console open through the repair and next reboot.
The console identifies systemd emergency mode and provides a maintenance shell; authentication and wording can vary by setup.
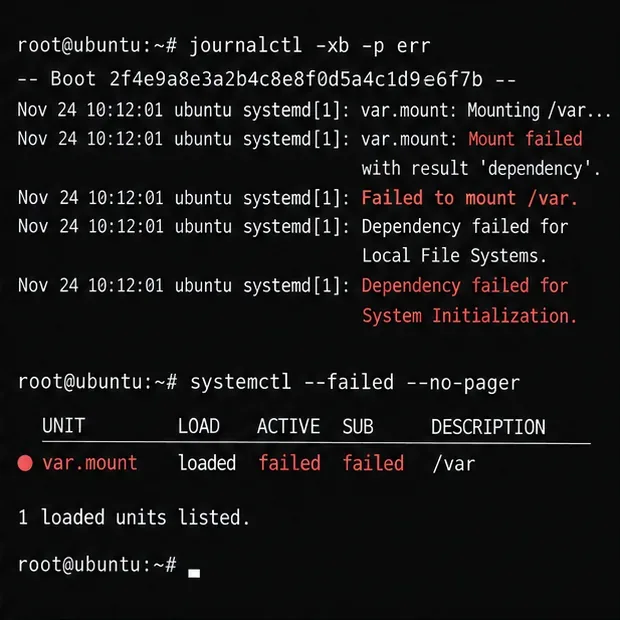
-b limits the journal query to this boot, and -p err filters for error priority and higher. Look for the first relevant error, not simply the last cascade of “dependency failed” messages. If a mount unit failed, note its escaped unit name and target path; if a service failed, identify whether it is a cause or only a consequence of a missing mount. Ubuntu’s journalctl(1) manual documents boot and unit filtering.
L'output rappresentativo del log di avvio indica un errore di dipendenza di montaggio; il nome effettivo dell'unità e il messaggio devono provenire dal server.
3. Verificare il punto di montaggio principale e lo spazio disponibile.
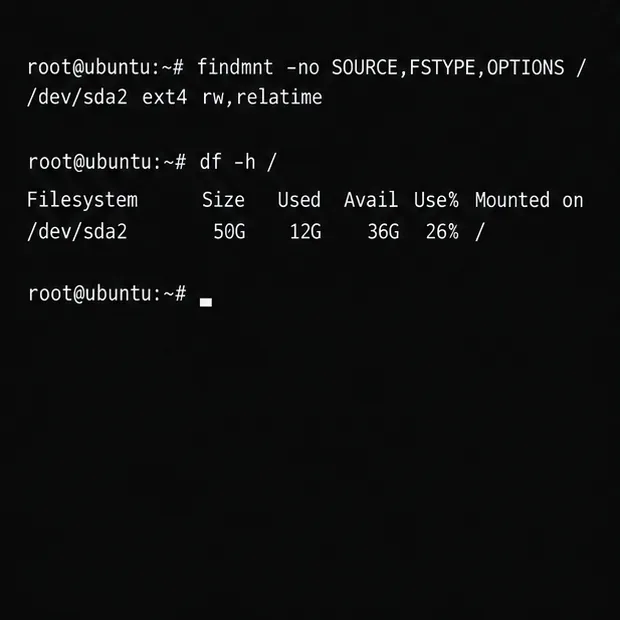
Prima di modificare i file o tentare riparazioni, verificare come è montato il filesystem root e se il sistema ha esaurito i blocchi o gli inode:
Nell'output findmnt, roindica sola lettura e rwindica lettura/scrittura. Una root di sola lettura può essere intenzionale durante una fase di ripristino, oppure può riflettere un problema del filesystem. Non forzare immediatamente un rimontaggio in modalità lettura/scrittura se i log del kernel segnalano errori di I/O o del filesystem. Un filesystem pieno o una tabella degli inode esaurita possono anche causare il fallimento di servizi e mount non correlati. Il findmnt(8)manuale di Ubuntu descrive come ispezionare i filesystem montati.
I comandi rivelano se la directory root è montata in sola lettura o in lettura/scrittura e se sono disponibili blocchi su disco.
4. Convalidare /etc/fstabe verificare gli identificativi del dispositivo
Poiché Casey ha recentemente apportato delle modifiche /etc/fstab, verifica sia la sua sintassi sia l'esistenza dei dispositivi a cui fa riferimento:
findmnt --verify --verbose
lsblk -f
blkid
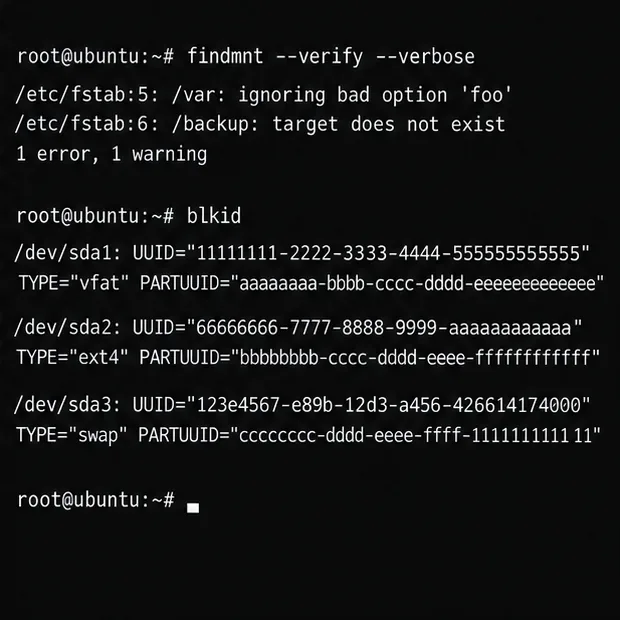
findmnt --verify --verboseControlla le voci di fstab per problemi di analisi e usabilità. Confronta ogni elemento UUID=nella riga sospetta con l'UUID mostrato da lsblk -fo blkid. Controlla anche il punto di montaggio, il tipo di filesystem e le opzioni. Un UUID copiato da un altro disco, un dispositivo non collegato o un'opzione non valida possono impedire il completamento di un montaggio richiesto. Non fare supposizioni su una partizione come /dev/sda1; i nomi dei dispositivi possono cambiare tra un avvio e l'altro.
Il validatore segnala problemi con fstab, mentre blkid elenca gli UUID dei dispositivi da confrontare con la voce sospetta.
5. Correggere solo il problema di montaggio confermato
Se il filesystem di root è scrivibile e il controllo fstab rileva una riga danneggiata, esegui un backup prima di modificarlo:
cp -a /etc/fstab /etc/fstab.before-rescue
nano /etc/fstab
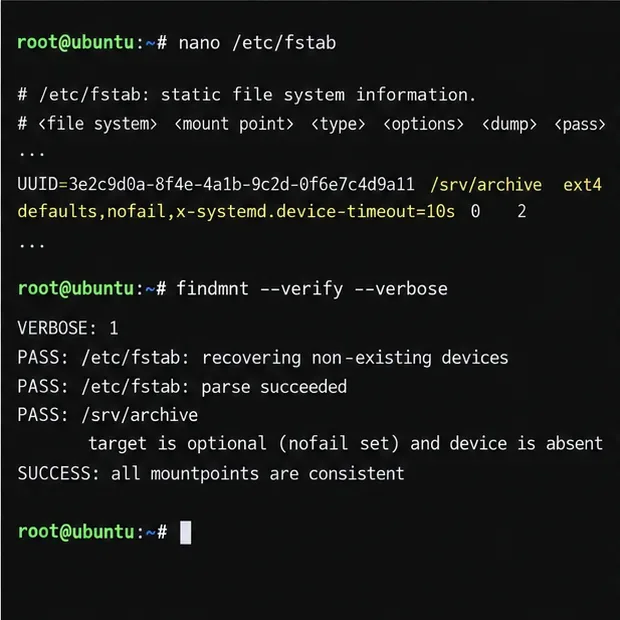
Correggi l'UUID o altri campi solo dopo aver confermato il dispositivo previsto. Se il mount è effettivamente opzionale e il server deve comunque avviarsi anche in assenza di tale volume, è possibile utilizzare una riga fstab compatibile con systemd nofaile un'attesa del dispositivo finito, ad esempio:
Sostituisci il segnaposto con l'UUID reale e usa il tipo di filesystem effettivo. Non aggiungere nofaila root, boot o altri filesystem necessari al corretto funzionamento della macchina o delle sue applicazioni. Con nofail, l'avvio procede anche se il mount fallisce, quindi i servizi dipendenti potrebbero comunque richiedere attenzione. Il manuale di Ubuntu systemd mount-unit documenta queste opzioni di fstab.
Dopo la modifica, convalida nuovamente prima di tentare il montaggio:
findmnt --verify --verbose
systemctl daemon-reload
mount /srv/archive
Utilizza il punto di mount effettivo nell'ultimo comando. Se l'operazione continua a fallire, leggi il nuovo messaggio di errore e verifica che il disco sia collegato e integro. Se il filesystem di root è di sola lettura, non forzare le modifiche alla cieca; utilizza un ambiente di ripristino del provider o un supporto di avvio di Ubuntu per ispezionare e modificare il sistema installato in modo sicuro.
L'esempio contrassegna come facoltativo solo il montaggio di un archivio non essenziale e controlla il file fstab successivamente.
6. Indagare su un servizio non riuscito solo quando il registro indica uno
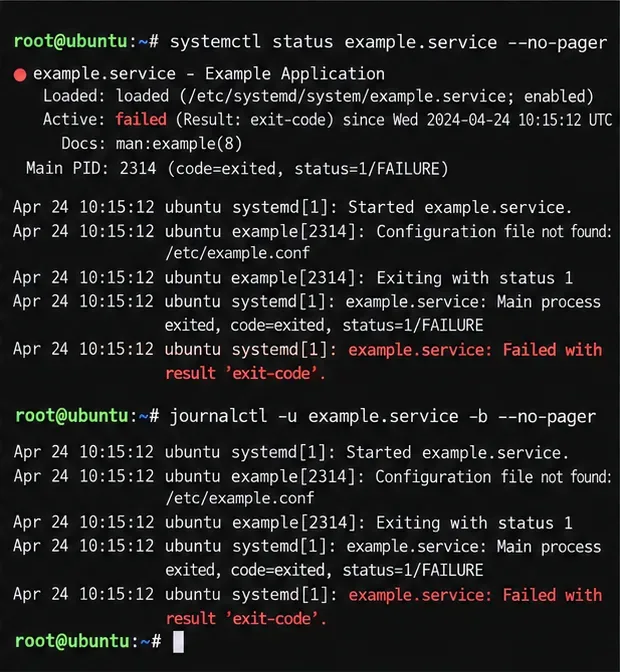
La modalità di emergenza non significa che ogni servizio non funzionante abbia causato l'arresto del sistema. Se l'errore in questione menziona un servizio, esaminate tale servizio e i relativi registri anziché mascherarlo o disabilitarlo:
systemctl status example.service --no-pager
journalctl -u example.service -b --no-pager
Sostituire example.servicecon il nome esatto dell'unità. Verificare se mancano il file di configurazione, l'eseguibile, le credenziali o il punto di montaggio necessario. Se l'errore si verifica a valle del volume dati mancante di Casey, correggere prima quel punto di montaggio e poi rivalutare il servizio. Disabilitare un servizio essenziale potrebbe nascondere il sintomo, rendendo il server inutilizzabile.
Lo stato del servizio e il registro aiutano a distinguere la causa principale di un errore dai guasti causati da un'altra dipendenza mancante.
7. Trattare gli errori del filesystem come un'attività di riparazione offline
Se il registro del kernel segnala danneggiamento del filesystem o errori di I/O di archiviazione, interrompere le operazioni di scrittura laddove possibile e conservare un backup o uno snapshot del provider prima della riparazione. Confermare il dispositivo e il filesystem esatti con lsblk -f. Per un filesystem root, avviare il sistema di ripristino del provider o il supporto di ripristino/live di Ubuntu, assicurarsi che la partizione di destinazione sia smontata e utilizzare lo strumento di verifica appropriato per quel filesystem. Per ext2/3/4, lo strumento è e2fsck; XFS, Btrfs e altri formati hanno procedure diverse.
Non eseguire mai operazioni fsckdi I/O e2fscksu un filesystem montato, inclusa una root di sola lettura montata. Il e2fsck(8)manuale di Ubuntu avverte che controllare un filesystem montato è generalmente pericoloso e che i risultati non sono validi. Se il disco segnala errori di I/O ripetuti, dai la priorità al recupero dei dati o al contatto con il fornitore di servizi di archiviazione piuttosto che tentare ripetutamente riparazioni.
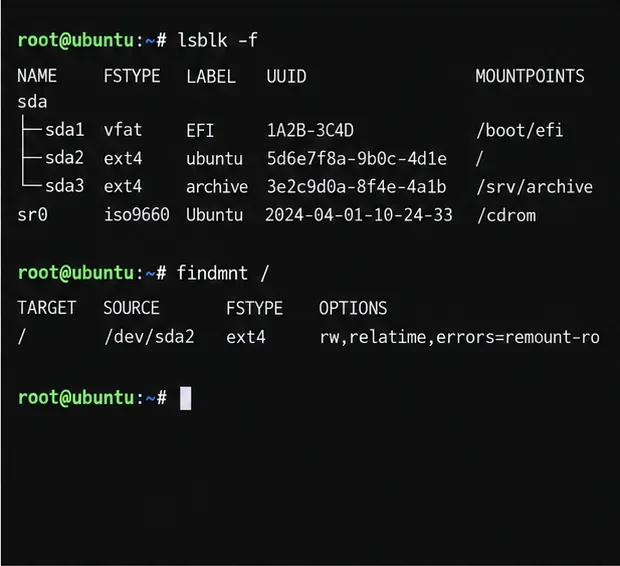
L'elenco dei dischi aiuta a identificare la partizione corretta; il filesystem root rimane montato, quindi non è pronto per fsck.
8. Riavviare il sistema normalmente e verificare il risultato.
Una volta risolta la causa accertata, riavviare dalla console:
systemctl reboot
Dopo l'avvio di Ubuntu, verificare il target predefinito configurato, lo stato attuale del sistema, le unità non funzionanti e il nuovo avvio:
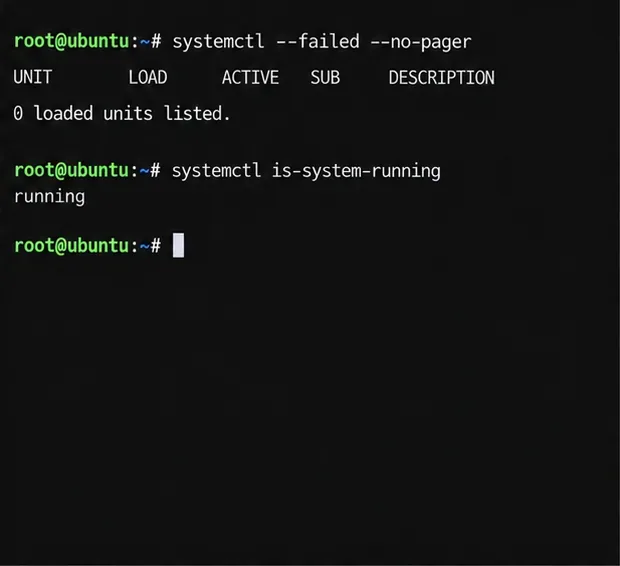
Se si continua intenzionalmente con l'avvio corrente, systemctl defaultchiede a systemd di avviare la destinazione predefinita configurata. Utilizzalo solo dopo aver risolto l'errore bloccante; non ripara un mount non valido o un filesystem danneggiato. systemctl get-defaultMostra la destinazione predefinita configurata; systemctl is-system-runningsegnala se systemd considera lo stato corrente in esecuzione, degradato o altro. Un ripristino pulito significa che i filesystem previsti sono montati, i servizi richiesti sono attivi e la stessa condizione di emergenza non si ripresenta dopo il riavvio.
Il terminale mostra i controlli di systemctl relativi alle unità guaste e se il sistema è in esecuzione dopo il riavvio.
Se il prompt è (initramfs)invece
Non applicare ciecamente i passaggi della shell di emergenza di systemd nell'initramfs di BusyBox. La fase initramfs tenta di individuare e montare il filesystem root effettivo prima di cedere il controllo al sistema installato. Registra l'errore esatto, verifica se il dispositivo previsto appare in /deve /dev/disk/by-uuid, e confronta il valore della riga di comando di avvio root=con l'UUID root effettivo. Se il disco o il volume crittografato/LVM non è presente, utilizza gli strumenti di archiviazione e ripristino del provider per indagare. Ricostruire l'initramfs o modificare i parametri di GRUB senza identificare il dispositivo mancante può rendere più difficile il ripristino dell'avvio.
Per la macchina virtuale ipotetica di Casey, il risultato utile è una causa verificata e una correzione mirata: ripristinare il volume opzionale previsto, correggere il suo identificatore confermato o configurarlo come opzionale solo se il carico di lavoro lo consente effettivamente. Quindi verificare il successivo avvio dalla console prima di chiudere la sessione di ripristino.