Attivare l'esecuzione automatica di Nextcloud Cron con un timer Systemd
Controlla la modalità cron di Nextcloud, ripara il servizio systemd e il timer e verifica che i processi in background vengano eseguiti dopo l'avvio e ogni cinque minuti.
Se durante un aggiornamento SLES segnala "Impossibile allocare memoria", verificare innanzitutto se il kernel ha registrato un evento di memoria insufficiente e se la RAM o lo swap sono esauriti. Mettere in pausa un carico di lavoro non essenziale noto o aumentare la memoria assegnata alla VM solo dopo aver verificato la pressione sul sistema, quindi verificare che Zypper e RPM non siano più attivi prima di riprendere la procedura di aggiornamento originale.
Esempio ipotetico: immaginiamo una macchina virtuale SLES 15 in cui un amministratore avvia un aggiornamento pianificato di un pacchetto mentre è in esecuzione un processo batch di grandi dimensioni. Zypper si arresta con un errore di allocazione della memoria. L'esempio seguente è puramente illustrativo e non rappresenta un incidente reale o un test; utilizzare i comandi per raccogliere prove sul proprio host prima di scegliere una soluzione.
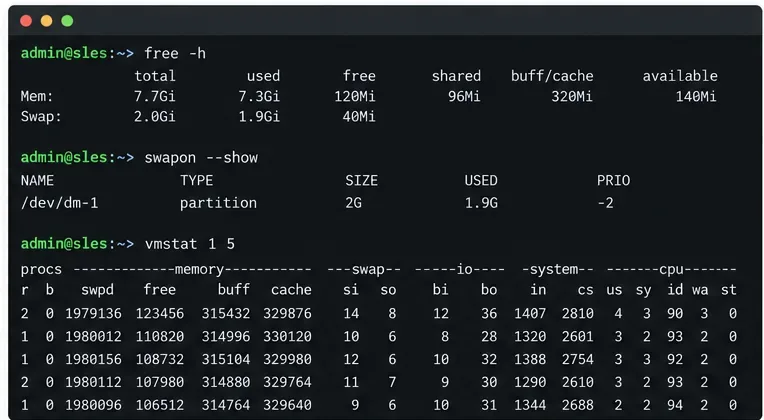
Non riavviare il sistema, non terminare i processi dei pacchetti e non avviare un secondo comando di aggiornamento solo perché la sessione SSH ha visualizzato un errore. Riconnettiti in una seconda sessione e verifica la presenza di processi Zypper o RPM attivi:
pgrep -a 'zypper|rpm'Se un processo di pacchetto è ancora in esecuzione, attendi che termini e controlla il suo output o i log. Non eliminare i file di blocco di Zypper mentre un'operazione di pacchetto potrebbe essere attiva. Se non è in esecuzione alcun processo, conserva il testo esatto dell'errore e annota quando si è verificato; tale timestamp aiuta a correlare i log del kernel e del pacchetto.
Raccogli un'istantanea della RAM e dello spazio di swap correnti:
free -h
swapon --show
vmstat 1 5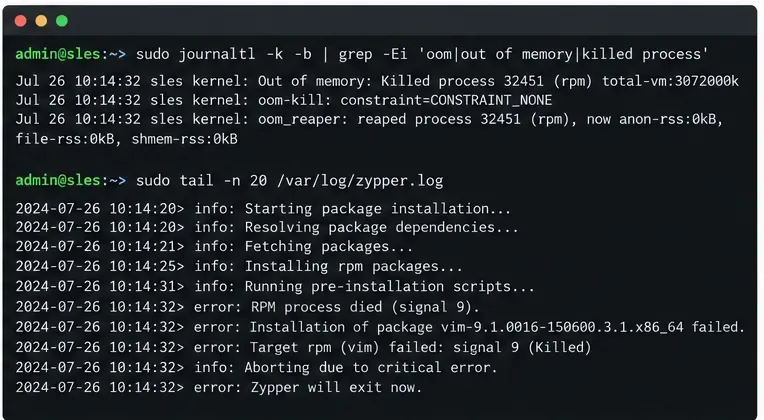
In free -h, controlla la availablecolonna, non solo la quantità contrassegnata free; Linux utilizza anche la RAM per la cache. swapon --showriporta se esiste lo swap e quanto ne viene utilizzato. In vmstat, valori ripetuti diversi da zero sie sonelle righe recenti indicano uno swap attivo; la prima riga è una media dall'avvio, quindi concentrati sulle righe successive.
Quindi cerca un errore di tipo kernel out-of-memory (OOM) in prossimità del punto in cui si è verificato l'errore e leggi il log di Zypper:
sudo journalctl -k -b --since "30 minutes ago" | grep -Ei 'oom|out of memory|killed process'
sudo tail -n 80 /var/log/zypper.log
Un record OOM-kill che menziona RPM, Zypper o un altro processo supporta una diagnosi effettiva di pressione sulla memoria. Una quantità insufficiente di RAM "libera" da sola non è sufficiente: la cache può essere recuperata e il messaggio può anche derivare da un limite di memoria di un processo o di un servizio. Se non viene visualizzata alcuna voce OOM del kernel, verificare i limiti del comando che ha causato l'errore e qualsiasi limite di memoria di systemd o del container prima di aggiungere memoria host. La causa esatta non può essere identificata dalla sola frase "Impossibile allocare memoria".
Tornare alla macchina virtuale ipotetica. Se il job batch sta consumando memoria e il sistema mostra un'attività di swap prolungata o un kernel OOM kill, utilizzare la procedura di pausa o arresto supportata dall'applicazione. Non terminare un database, un carico di lavoro SAP o altri servizi con stato senza seguire le procedure di arresto previste dall'operatore. Verificare nuovamente la RAM e lo swap dopo aver messo in pausa il carico di lavoro.
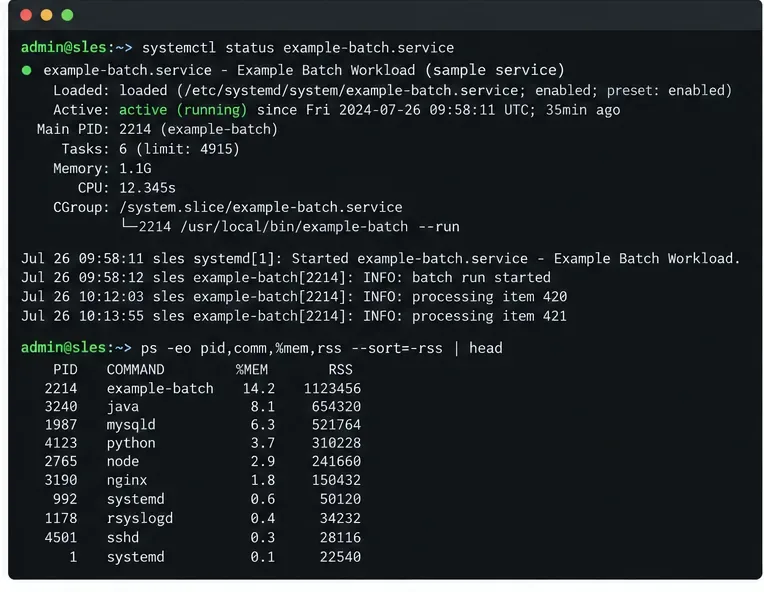
Se durante la normale manutenzione la memoria del sistema guest risulta insufficiente, aumentare la RAM assegnata tramite l'hypervisor supportato o il piano di controllo cloud, quindi verificare che il sistema operativo rilevi la nuova quantità. L'aggiunta di swap può fornire un margine temporaneo, ma è più lenta della RAM e non risolve i problemi di memoria persistente. La configurazione dello storage SLES è importante: ad esempio, SUSE documenta vincoli specifici per i file di swap su Btrfs. Evitare di creare o ridimensionare lo swap durante un aggiornamento, a meno che non si siano verificati i requisiti del filesystem, dello snapshot e della piattaforma.
In assenza di record OOM, esaminare invece il limite applicato al processo che ha causato l'errore. Su SLES 15, controllare il limite di memoria configurato per un carico di lavoro gestito da systemd, sostituendo il nome dell'unità di esempio con il servizio interessato:
sudo systemctl show example-batch.service -p MemoryMaxConfronta quel valore con la memoria disponibile. Un limite cgroup non verrà risolto aumentando la RAM della VM a meno che anche il limite non venga aumentato in modo appropriato. Nei service pack meno recenti, verifica il nome della proprietà confrontandolo con la documentazione di systemd di quella versione.
Una volta terminato il processo di creazione del pacchetto, verificare /var/log/zypper.logl'ultima azione completata e l'eventuale presenza di pacchetti non riusciti. Se RPM o Zypper segnalano una transazione incompleta, seguire le istruzioni di ripristino di SUSE specifiche per quell'errore prima di riprovare. Non rimuovere manualmente i file del database dei pacchetti o i blocchi.
Utilizza lo stesso percorso di aggiornamento che hai iniziato inizialmente. La manutenzione ordinaria dei pacchetti e la migrazione di un service pack sono operazioni diverse: la documentazione SUSE zypper patchdescrive come installare le patch rilasciate applicabili, mentre gli aggiornamenti dei service pack e delle versioni principali hanno percorsi e preparazioni specifici. Non passare a questa opzione zypper dupsemplicemente per una soluzione temporanea relativa alla memoria. Per un'esecuzione ordinaria di una patch, rivedi prima la transazione:
sudo zypper patch --dry-run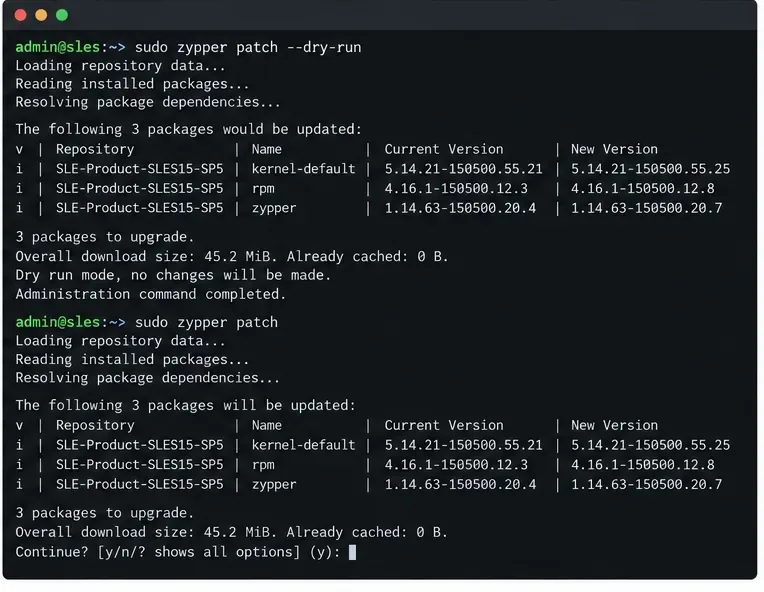
Se la simulazione a secco mostra un piano ragionevole e la memoria è stabile, pianifica una finestra di manutenzione ed esegui il comando appropriato per l'attività originale. Mantieni la sessione SSH attiva, monitora il processo e verifica il risultato in seguito.
sudo tail -n 80 /var/log/zypper.log
sudo journalctl -k -b --since "30 minutes ago" | grep -Ei 'oom|out of memory|killed process'
Un ripristino riuscito significa che i pacchetti o la migrazione previsti sono stati completati, Zypper è terminato correttamente e non si è verificato alcun nuovo evento OOM durante l'esecuzione. Se il sistema è avviabile ma è necessario annullare la migrazione di un service pack SLES, la procedura di rollback di Snapper documentata da SUSE si applica solo se i requisiti sono soddisfatti, tra cui una directory root Btrfs supportata e snapshot configurati. Non considerare il rollback come una risposta generica a un errore di applicazione di un pacchetto.
Se l'errore si ripete dopo che la pressione sulla memoria è stata alleviata, i processi dei pacchetti sono ancora bloccati o il database RPM segnala un danneggiamento, interrompere i tentativi. Conservare il log di Zypper, il journal del kernel, il livello del prodotto e del service pack e il comando esatto utilizzato. SUSE supportconfigpuò raccogliere dati diagnostici per una richiesta di supporto. I passaggi qui descritti aiutano a distinguere la pressione sulla memoria da altri errori di allocazione; non possono determinare un difetto specifico del prodotto senza i log completi e la configurazione del sistema.
Per i dettagli aggiornati di SLES 15 SP7, consultare le utilità di monitoraggio del sistema di SUSE , il riferimento ai file di registro , la guida di amministrazione di Zypper , i requisiti di swap e Btrfs e le istruzioni online per l'aggiornamento e il rollback . I comandi e i percorsi di ripristino possono variare a seconda del service pack di SLES, dell'architettura, del filesystem e del fatto che l'operazione sia di applicazione di patch o di migrazione della release.
Controlla la modalità cron di Nextcloud, ripara il servizio systemd e il timer e verifica che i processi in background vengano eseguiti dopo l'avvio e ogni cinque minuti.
Abilita il blocco affidabile dei file in Nextcloud, scegli il backend Redis o Valkey più adatto e verifica che l'avviso scompaia senza rischiare modifiche simultanee ai file.
Risolvi i problemi più comuni riscontrati durante le scansioni di Nextcloud con gli aggiornamenti più recenti, HTTPS e HSTS, una configurazione precisa del proxy inverso e verifiche rispetto al server pubblico.
Configura Nextcloud SSE per lo spazio di archiviazione che lo richiede, proteggi le chiavi di crittografia e misura l'impatto sul trasferimento dati e sulla CPU prima di crittografare i file esistenti.
Collega la ricerca file di Nextcloud a Elasticsearch, indicizza il contenuto dei documenti e scegli una configurazione adatta alle esigenze del tuo server e della tua sicurezza.
Configura Nextcloud per rimuovere i file eliminati dopo un periodo di conservazione definito, pianifica in modo affidabile le attività in background ed evita i comandi che svuotano il cestino di tutti gli utenti.
Esegui in modo sicuro la riparazione OCC di Nextcloud, visualizza in anteprima le modifiche al database e verifica il motivo per cui l'avviso potrebbe persistere.
Consenti il caricamento di file di dimensioni maggiori nel browser Nextcloud allineando le impostazioni di PHP, Nginx o Apache, dello spazio di archiviazione temporaneo e del timeout, e verifica quale limite sta bloccando il file.
Imposta il limite di memoria PHP effettivamente utilizzato da Nextcloud, riavvia il servizio corretto e conferma l'impostazione di 512 MB nella Panoramica di amministrazione.
Monta un bucket di object storage compatibile in Nextcloud utilizzando il suo backend S3, con l'endpoint, le credenziali, l'ambito di accesso e i passaggi di verifica corretti.



