Home
» Come fare
»
Diagnosticare un server SUSE che si blocca nella schermata di arresto di systemd
Diagnosticare un server SUSE che si blocca nella schermata di arresto di systemd
Se SUSE Linux Enterprise Server si blocca durante lo spegnimento tramite systemd, identifica l'unità con un processo di arresto in esecuzione o esamina i messaggi finali dell'avvio precedente, quindi correggi tale unità o una sua dipendenza. Un'unità è una risorsa gestita da systemd, come un servizio o un punto di montaggio; un processo di arresto è la richiesta di systemd di arrestarne una. Non ridurre il timeout globale né forzare lo spegnimento come prima soluzione, perché un servizio o un filesystem potrebbero essere ancora in fase di chiusura di file o scrittura di dati.
Questa procedura dettagliata si basa sulla documentazione di SLES 15 SP7 verificata nell'ottobre 2026. La politica di arresto esatta dipende dal fornitore del servizio e dello storage, pertanto si consiglia di fare riferimento alle loro linee guida per eventuali modifiche specifiche dell'unità.
1. Osservare lo spegnimento in sicurezza
Passaggio 1: Registra il messaggio esatto e attendi prove utili
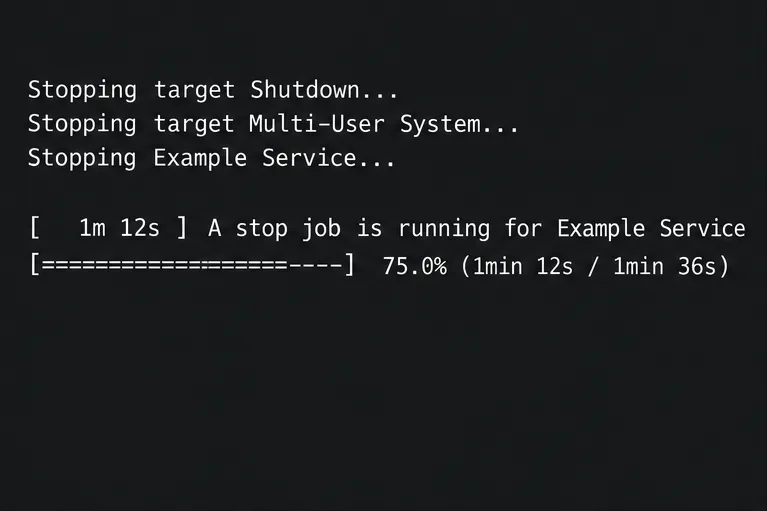
Se la console mostra "È in corso un'operazione di arresto per..." con un conto alla rovescia, annota il servizio o il punto di montaggio specificato e se il timer cambia. Ciò significa che systemd è in attesa dell'operazione di arresto di tale unità, non necessariamente che il sistema operativo si sia bloccato; i database e lo storage remoto potrebbero aver bisogno di tempo per chiudersi correttamente.
Un esempio di messaggio nella console indica l'unità che systemd è in attesa; il servizio visualizzato e il conto alla rovescia sono a scopo illustrativo.
Monitorare il sistema tramite console remota o seriale, oppure tramite un altro terminale disponibile. Evitare comandi di reset o di accensione/spegnimento mentre sono in corso operazioni di scrittura. Se il sistema smette di rispondere, annotare l'ultima riga visualizzata e continuare dopo il riavvio.
2. Trova l'unità in attesa
Passaggio 2: Verifica i processi systemd per accertarti che la macchina accetti ancora i comandi.
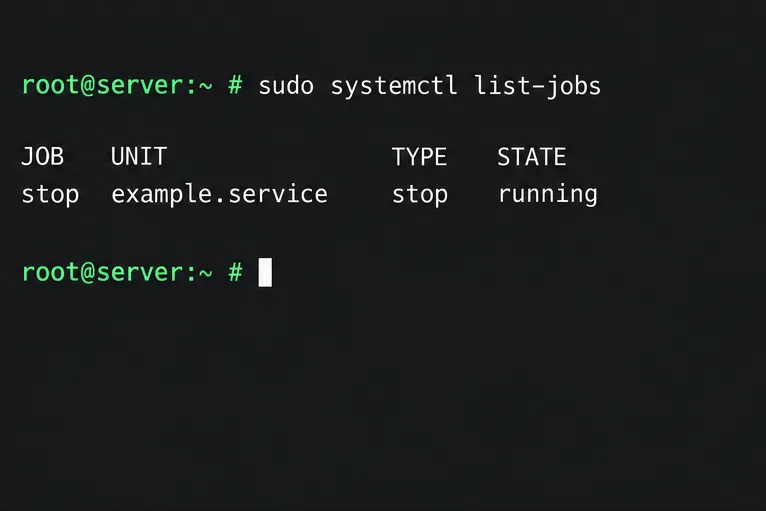
Se SSH o un secondo terminale funzionano ancora, chiedi a systemd quali processi sono in esecuzione o in attesa, quindi controlla l'unità indicata sullo schermo:
sudo systemctl list-jobs
sudo systemctl status SERVICE.service
L'elenco dei processi può identificare un servizio la cui operazione di arresto è ancora in corso; la riga mostrata è un esempio.
Sostituire SERVICEcon il nome effettivo dell'unità. Un processo di arresto in esecuzione restringe la ricerca, ma non spiega perché il processo non è terminato. Leggere lo stato e i log prima di modificare la configurazione. Se systemd non risponde più, non annullare i processi alla cieca; esaminare il journal precedente dopo il ritorno dell'host.
3. Utilizzare l'avvio precedente per identificare la causa
Passaggio 3: Leggere la fine del diario di avvio precedente
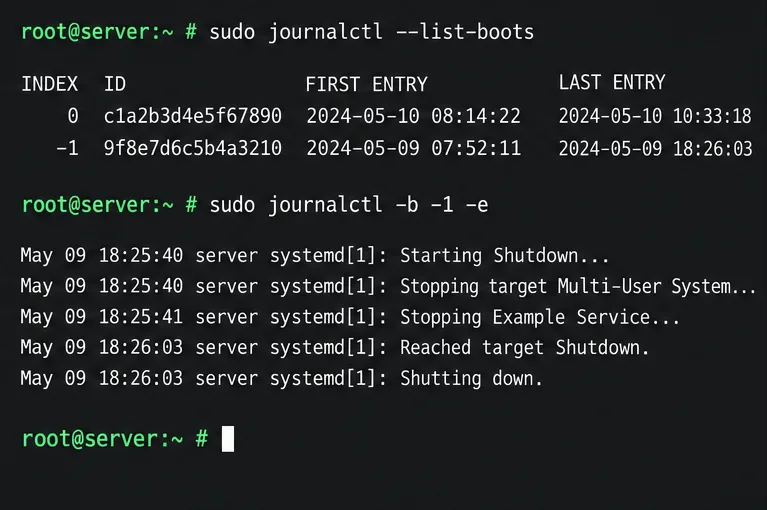
Il journal è il registro indicizzato di systemd dei messaggi del kernel, dei servizi e del sistema. Dopo il successivo avvio riuscito, elenca gli avvii registrati e controlla la fine dell'avvio precedente:
L' -1offset seleziona l'avvio precedente e -esi sposta sulle sue voci più recenti.
Cerca l'ultimo messaggio "Arresto in corso", un timeout, dei tentativi o un dispositivo o un punto di montaggio specificato. L'ultima riga è solo un indizio: l'ordine di arresto potrebbe lasciare un'altra unità in attesa. Confronta i timestamp con i messaggi vicini.
Passaggio 4: Filtrare i log per il servizio sospetto
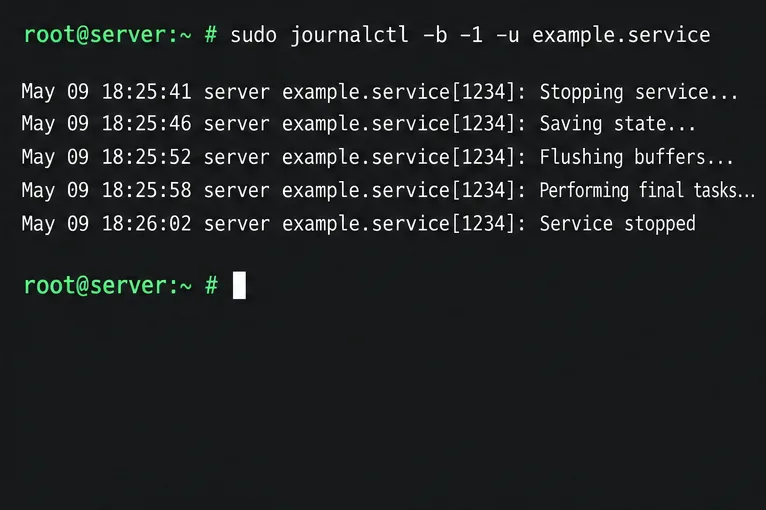
Quando la schermata o il registro indicano un servizio, interroga solo le voci di avvio precedenti di tale unità. Esamina anche la configurazione caricata:
Il filtraggio per unità aiuta a distinguere un arresto lento del servizio da messaggi non correlati presenti in altre parti del registro.
Verificare la presenza di un file personalizzato ExecStop, di uno script che attende indefinitamente, di un processo figlio persistente o di un errore dell'applicazione nel suo hook di arresto. Per le unità di terze parti, confrontare il pacchetto e la configurazione con le linee guida supportate prima di apportare modifiche.
Passaggio 5: Controllare i supporti e la conservazione solo quando le prove indicano che
Se il journal specifica un mount, un dispositivo o un filesystem remoto, ispeziona la tabella dei mount e la voce corrispondente in /etc/fstab:
sudo findmnt --verify --verbose
Utilizzare la verifica del montaggio quando i log indicano un problema con il punto di montaggio; le voci visualizzate sono a scopo illustrativo e devono essere confrontate con l'host.
Verifica se una dipendenza remota NFS, CIFS, iSCSI o di altro tipo è raggiungibile e prevista durante lo spegnimento. Rimuovi una voce di montaggio obsoleta solo dopo aver verificato che non venga utilizzata. Non smontare forzatamente un filesystem attivo basandoti solo su un riavvio lento.
4. Risolvi la causa senza nasconderla
Passaggio 6: Riparare il servizio o modificare solo la relativa politica di arresto documentata.
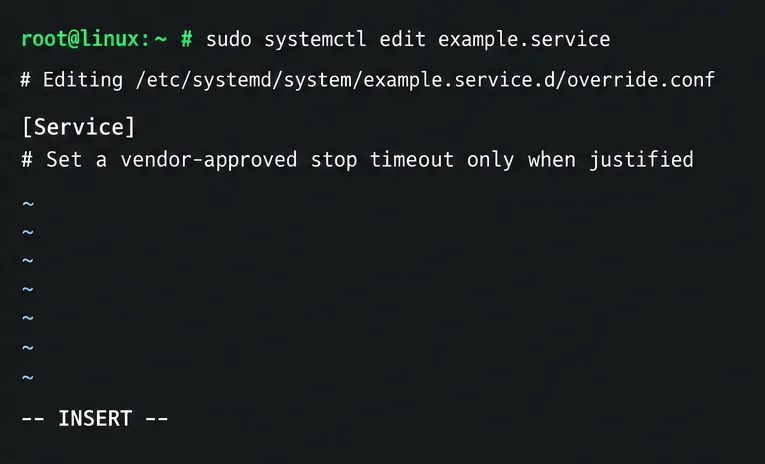
Per un servizio che non si arresta, correggere prima lo script di arresto, la configurazione dell'applicazione o il problema del pacchetto. Un drop-in per unità sudo systemctl edit SERVICE.serviceviene memorizzato in /etc/systemd/system/senza modificare il file del fornitore. Documentare SUSE TimeoutSecper l'avvio o l'arresto del servizio; utilizzare un valore approvato dal fornitore per questo carico di lavoro.
Un'unità drop-in può contenere un override mirato; la nota mostrata è indicativa, non un valore di timeout.
Dopo una modifica documentata, ricarica le definizioni delle unità di systemd con sudo systemctl daemon-reloade ispeziona il risultato con sudo systemctl cat SERVICE.service. Un timeout più lungo può consentire il completamento di uno spegnimento legittimo, ma può anche prolungare un riavvio non riuscito. Un timeout più breve può terminare un servizio prima che svuoti lo stato. Non modificare le impostazioni predefinite globali per nascondere il difetto di una singola unità.
Passaggio 7: Conservare i registri per il prossimo incidente
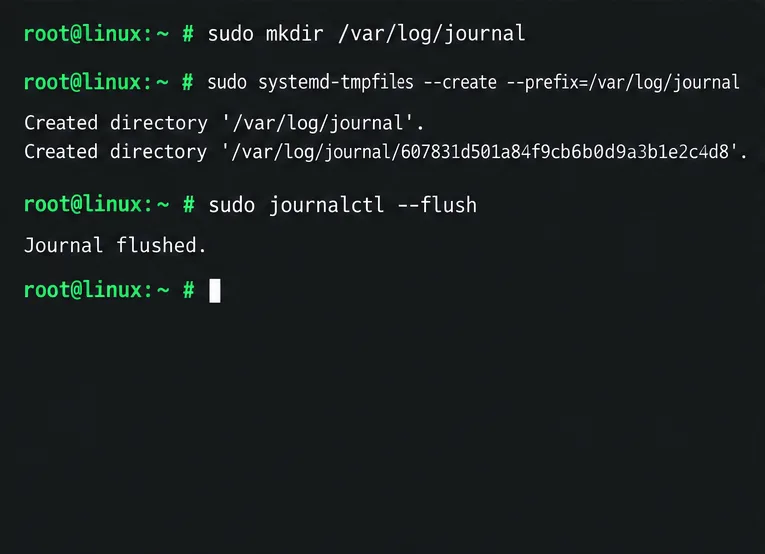
SLES memorizza i dati del journal in /run/log/journal/una directory predefinita, che viene svuotata al riavvio. Se journalctl -b -1non sono presenti voci di avvio precedenti, abilitare la memorizzazione persistente del journal per future diagnosi:
Questi comandi preservano le nuove voci del registro anche dopo il riavvio; non possono ripristinare i registri già persi dalla memoria volatile.
I log persistenti utilizzano lo spazio sotto /var; SUSE fa notare che il journal può utilizzare fino al 10% di tale filesystem per impostazione predefinita. Verificare lo spazio libero e la conservazione, soprattutto su /varvolumi di piccole dimensioni.
5. Verificare il prossimo riavvio pianificato
Passaggio 8: Verificare che l'arresto sia stato completato e che il server sia tornato in servizio.
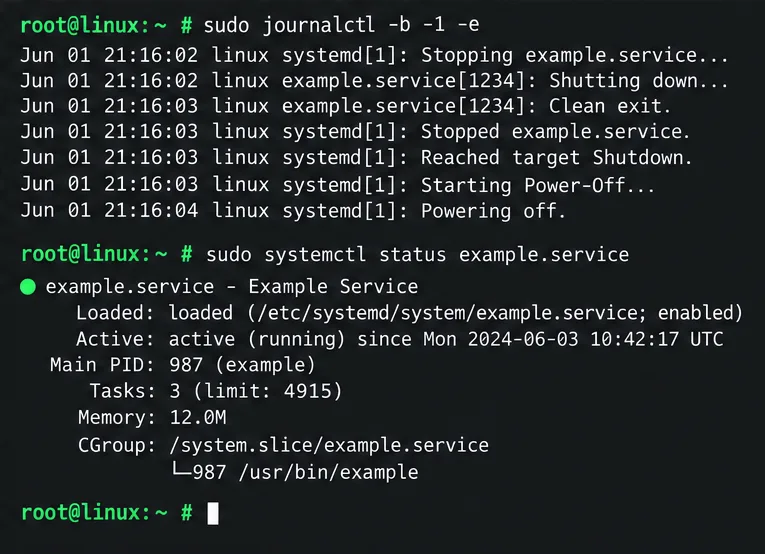
Una volta risolta la causa sospetta, pianifica un riavvio controllato con accesso alla console. Dopo il riavvio del sistema, esamina i messaggi finali dell'avvio precedente e verifica lo stato attuale del servizio:
sudo journalctl -b -1 -e
sudo systemctl status SERVICE.service
Dopo un successivo riavvio, verificare che l'arresto precedente abbia visualizzato i messaggi finali e che il servizio sia di nuovo integro; questa è una visualizzazione di esempio, non una prova di test.
Il problema si risolve quando il server si arresta senza attendere la stessa unità, si avvia normalmente e il servizio o il mount funzionano. Se i log terminano bruscamente o mostrano errori del kernel, del controller o dell'hardware, conservateli e indagate con SUSE o il fornitore dell'hardware invece di modificare i timeout.