Attivare l'esecuzione automatica di Nextcloud Cron con un timer Systemd
Controlla la modalità cron di Nextcloud, ripara il servizio systemd e il timer e verifica che i processi in background vengano eseguiti dopo l'avvio e ogni cinque minuti.
Per SLES 15, registra l'estensione SUSE Linux Enterprise High Availability, quindi utilizza crm cluster inite crm cluster joinper avviare i nodi. Prima di posizionare i servizi sul cluster, verifica la ridondanza della rete, il fencing dei nodi (STONITH) e il quorum.
Questa procedura segue la documentazione di SLE HA 15 SP7 aggiornata a ottobre 2026. Verificare il service pack installato e l'architettura della CPU; gli identificativi di registrazione e i dettagli di supporto possono variare.
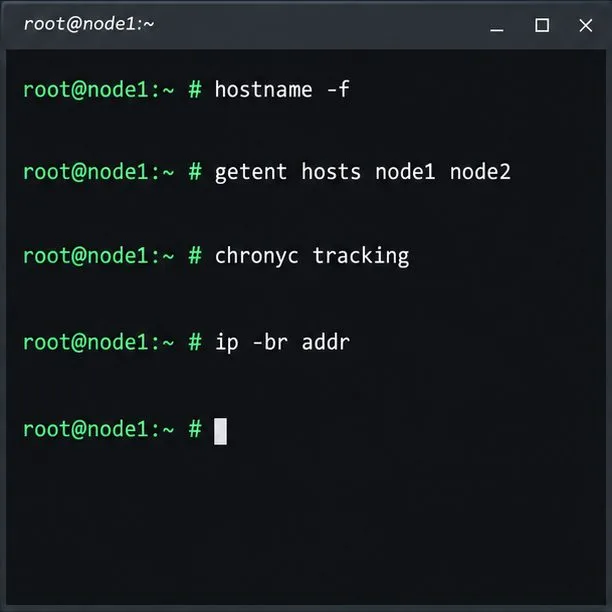
Utilizzare almeno due nodi con la stessa architettura di processore supportata, indirizzi IP primari statici, nomi univoci risolvibili su ogni nodo e orologi sincronizzati tramite una sorgente oraria esterna. SUSE richiede due percorsi di comunicazione TCP/IP ridondanti per nodo; i nomi delle interfacce devono corrispondere su tutti i nodi.
hostname -f
getent hosts node1 node2
chronyc tracking
ip -br addr
Eseguire i controlli su entrambi i nodi e verificare che le interfacce e i nomi selezionati siano corretti prima di avviare il bootstrapping.
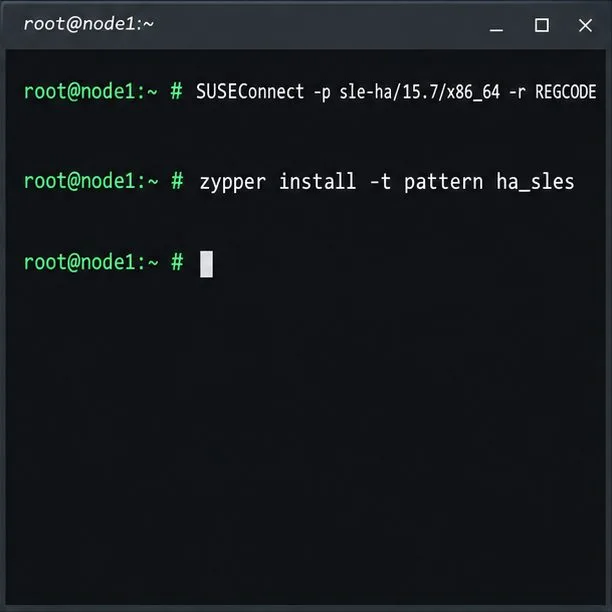
SLE HA è un'estensione registrata separatamente; SLES da solo non include il pattern cluster. Per i nodi SLES 15 SP7 x86_64 registrati, abilitare l'estensione e installare il pattern su ogni nodo:
SUSEConnect -p sle-ha/15.7/x86_64 -r ADDITIONAL_REGCODE
zypper install -t pattern ha_sles
Sostituisci ADDITIONAL_REGCODEcon il tuo codice di abbonamento. L'identificativo del prodotto è per x86_64; usa l'identificativo corrispondente di SUSE per altre architetture. Mantieni tutti i nodi allo stesso livello di SLES SP e SLE HA. Consulta la guida all'installazione di SLES HA 15 SP7 di SUSE .
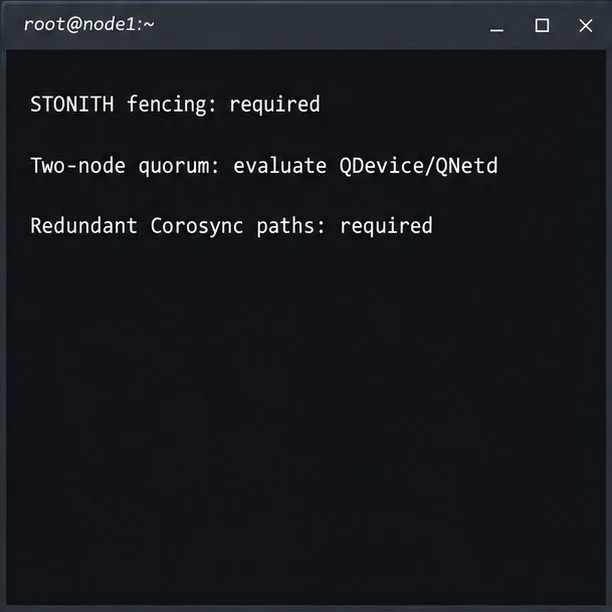
Obbligatorio per i cluster supportati: fencing dei nodi (STONITH), con stonith-enablede startup-fencinglasciato su true. Il fencing isola un nodo incerto per impedire che entrambi i lati di una partizione eseguano lo stesso servizio. Scegliere un dispositivo di controllo dell'alimentazione o un SBD supportato con un watchdog testato per il proprio hardware o hypervisor.
Per due nodi: SUSE consiglia QDevice/QNetd per cluster con un numero pari di nodi. Aggiunge un voto di quorum indipendente, non un meccanismo di fencing; se si include QDevice durante il bootstrap, configurare prima il server QNetd separato. Consultare la guida di QDevice e QNetd .
Un'idea errata sullo storage: lo storage condiviso non è obbligatorio per ogni cluster, ma i dati delle applicazioni necessitano di una propria architettura condivisa, replicata o ripristinabile. Pacemaker sposta le risorse; non copia i dati delle applicazioni.
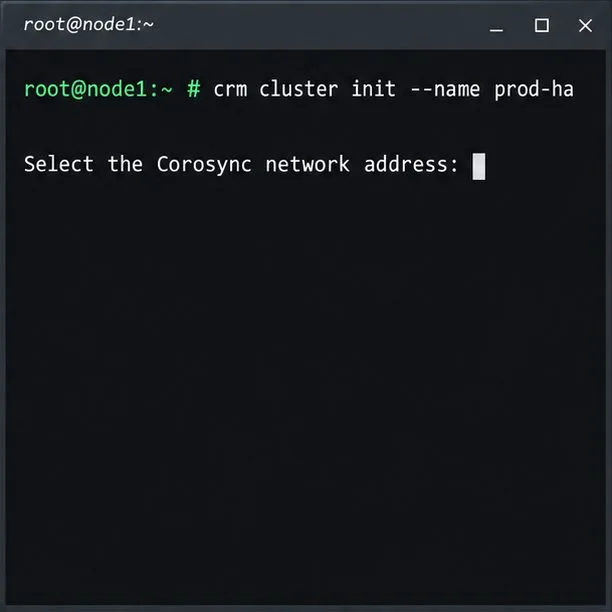
Sul nodo 1, avviare il bootstrap di CRM Shell come root o tramite la configurazione sudo approvata:
crm cluster init --name prod-haSegui le istruzioni e seleziona l'indirizzo Corosync desiderato. Lo script configura Corosync, SSH, Csync2, le porte del firewall del cluster e Hawk2; verifica la sincronizzazione dell'ora e offre opzioni per SBD e un indirizzo IP di amministrazione di Hawk2. Controlla /var/log/crmsh/crmsh.logle impostazioni di bootstrap.
Configura il watchdog su ciascun nodo prima di selezionare SBD. Se utilizzi il fencing esterno, configura la risorsa STONITH supportata prima dei carichi di lavoro. Non disabilitare mai STONITH per aggirare un dispositivo mancante. Il bootstrap crea un cluster di base, non un'applicazione HA.
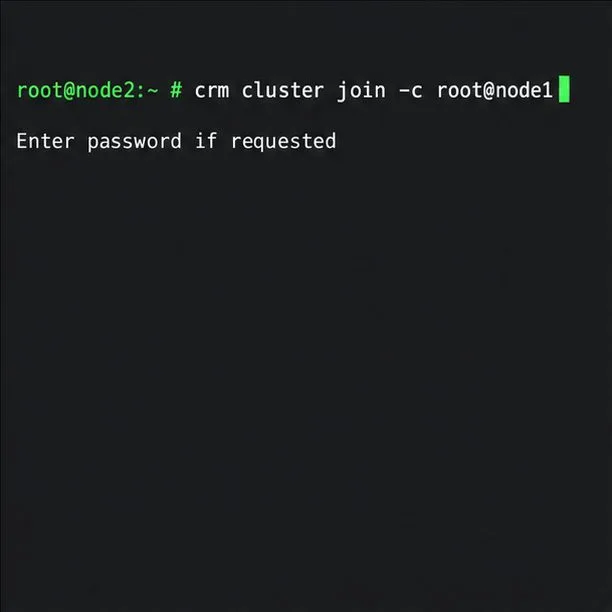
Installa e registra SLE HA sul nodo2. Se utilizzi SBD, prepara il relativo watchdog prima di unirti. Quindi, come root:
crm cluster join -c root@node1Per una configurazione con sudo-user, utilizzare la procedura di SUSE USER@NODE1. Specificare le stesse due interfacce se configurate all'avvio. Lo script copia le impostazioni di Corosync, configura SSH e Csync2 e porta online il nodo 2. Ripetere l'operazione per altri nodi; non utilizzare contemporaneamente i metodi di bootstrap e di configurazione di YaST.
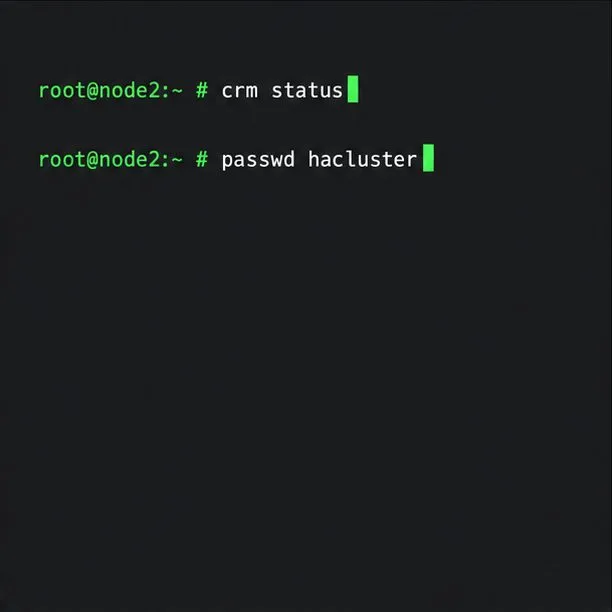
Da un nodo del cluster, verificare l'appartenenza:
crm statusVerifica che entrambi i nodi siano online e che sia presente il quorum. Il bootstrap crea haclusterla password iniziale linux; modificala su ciascun nodo inizializzato:
passwd haclusterHawk2 utilizza HTTPS sulla porta 7630. Verifica un certificato autofirmato con il tuo amministratore prima di considerarlo attendibile. L'indirizzo IP di gestione di Hawk2 non è l'indirizzo IP del client dell'applicazione.
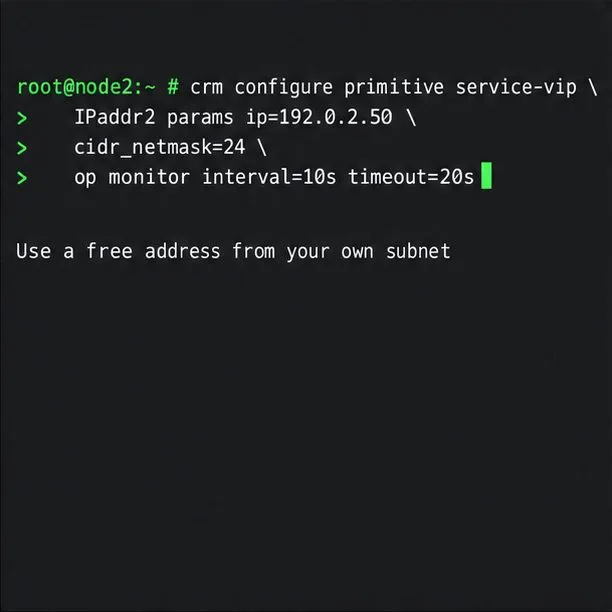
Pacemaker gestisce i servizi tramite agenti di risorse. Installa e configura il carico di lavoro in modo appropriato sui nodi idonei. Questo esempio crea solo un indirizzo IP mobile:
crm configure primitive service-vip IPaddr2 params ip=192.0.2.50 cidr_netmask=24 op monitor interval=10s timeout=20s192.0.2.50è riservato alla documentazione. Sostituisci con un indirizzo libero e il prefisso corretto della tua sottorete. Un primitivo IP non avvia un'applicazione né replica i dati. Aggiungi l'agente supportato dall'applicazione, oltre all'ordinamento, alla colocation e al comportamento di archiviazione specifici del carico di lavoro; segui le istruzioni di ripristino e di fencing del prodotto.
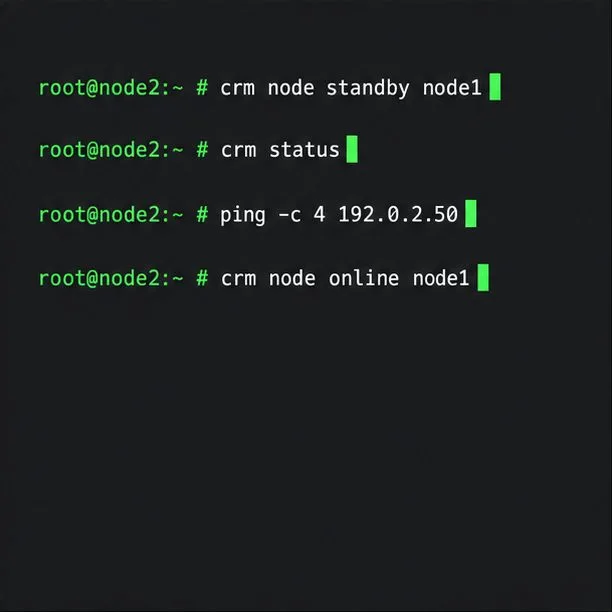
Dopo aver configurato le risorse reali e il fencing, pianifica un test di failover controllato. Metti il nodo 1 in standby e verifica il servizio dal nodo 2:
crm node standby node1
crm status
ping -c 4 SERVICE_VIP
crm node online node1
Sostituisci SERVICE_VIPcon l'indirizzo IP reale del client. Verifica che l'applicazione risponda, che le risorse vengano spostate come previsto e che il nodo 1 si riconnetta. Il ping controlla solo la raggiungibilità della rete. SUSE crm cluster crash_testinterrompe intenzionalmente i componenti, quindi utilizzalo in un ambiente di test pianificato. Leggi la guida rapida all'installazione e alla configurazione di SLE HA .
Dopo i test, verificare che entrambi i nodi abbiano lo stato previsto, che il fencing rimanga attivo e che il carico di lavoro risponda tramite il suo endpoint client dopo che il nodo 1 torna online. Una visualizzazione verde dell'appartenenza o un ping riuscito da soli non sono sufficienti a dimostrare il ripristino dell'applicazione.
Controlla la modalità cron di Nextcloud, ripara il servizio systemd e il timer e verifica che i processi in background vengano eseguiti dopo l'avvio e ogni cinque minuti.
Abilita il blocco affidabile dei file in Nextcloud, scegli il backend Redis o Valkey più adatto e verifica che l'avviso scompaia senza rischiare modifiche simultanee ai file.
Risolvi i problemi più comuni riscontrati durante le scansioni di Nextcloud con gli aggiornamenti più recenti, HTTPS e HSTS, una configurazione precisa del proxy inverso e verifiche rispetto al server pubblico.
Configura Nextcloud SSE per lo spazio di archiviazione che lo richiede, proteggi le chiavi di crittografia e misura l'impatto sul trasferimento dati e sulla CPU prima di crittografare i file esistenti.
Collega la ricerca file di Nextcloud a Elasticsearch, indicizza il contenuto dei documenti e scegli una configurazione adatta alle esigenze del tuo server e della tua sicurezza.
Configura Nextcloud per rimuovere i file eliminati dopo un periodo di conservazione definito, pianifica in modo affidabile le attività in background ed evita i comandi che svuotano il cestino di tutti gli utenti.
Esegui in modo sicuro la riparazione OCC di Nextcloud, visualizza in anteprima le modifiche al database e verifica il motivo per cui l'avviso potrebbe persistere.
Consenti il caricamento di file di dimensioni maggiori nel browser Nextcloud allineando le impostazioni di PHP, Nginx o Apache, dello spazio di archiviazione temporaneo e del timeout, e verifica quale limite sta bloccando il file.
Imposta il limite di memoria PHP effettivamente utilizzato da Nextcloud, riavvia il servizio corretto e conferma l'impostazione di 512 MB nella Panoramica di amministrazione.
Monta un bucket di object storage compatibile in Nextcloud utilizzando il suo backend S3, con l'endpoint, le credenziali, l'ambito di accesso e i passaggi di verifica corretti.



